Eine AI Freundin ist kein einzelnes Modell hinter einer Chatblase. Sie ist eine Anwendung, die mehrere Systeme koordiniert: ein Sprachmodell für die Konversation, Charakteranweisungen für die Persönlichkeit, Speicher für ausgewählte Historien, Moderation für Grenzen und manchmal separate Modelle für Bilder, Video, Spracherkennung und Stimme.
Das Erlebnis kann sich unmittelbar und persönlich anfühlen, weil die Anwendung diese Teile vor jeder Antwort zusammenstellt. Deine Nachricht wird nicht einfach an eine digitale Person gesendet, die sich an ein Leben erinnert. Sie wird Teil einer strukturierten Anfrage an eine generative Software.
Dieser Leitfaden verfolgt diese Anfrage ab dem Moment, in dem du auf Senden drückst. Er vermeidet es vorzugeben, dass jedes Unternehmen dieselbe Architektur verwendet; Implementierungen unterscheiden sich und proprietäre Details werden oft nicht offengelegt. Die nachfolgende Pipeline beschreibt gängige Designmuster, keine Behauptung über einen unbenannten Dienst. Um die Frage "wie funktioniert eine ai freundin" wirklich zu beantworten, müssen wir tief in die technische und psychologische Ebene dieser Interaktionen eintauchen.
Die komplette Pipeline auf einen Blick
| Phase | Was die Anwendung tut | Was du bemerkst |
|---|---|---|
| Eingabe | Akzeptiert Text, Audio, Bild oder Auswahl | Du sendest eine Nachricht oder startest einen Anruf |
| Orchestrierung | Fügt Charakter, Regeln, aktuellen Chat, Gedächtnis hinzu | Die Antwort klingt wie die gewählte Begleiterin |
| Generierung | Modell sagt Text- oder Medienausgabe voraus | Wörter erscheinen oder ein Job beginnt |
| Sicherheit | Prüft Anfrage und Ausgabe gegen Regeln | Inhalt kann erlaubt, geändert oder abgelehnt werden |
| Speicherung | Speichert Nachrichten, Zusammenfassungen, Metadaten oder Medien | Gespräch kann später fortgesetzt werden |
| Zustellung | Streamt Text/Audio oder gibt eine Medien-URL zurück | Du siehst oder hörst das Ergebnis |
| Abrechnung | Zieht Plan-Kontingent oder Nutzungs-Credits ab | Guthaben oder Berechtigung ändert sich |
Nicht jede Phase findet in dieser Reihenfolge statt. Die Sicherheit kann sowohl vor als auch nach der Generierung prüfen. Das Gedächtnis kann asynchron aktualisiert werden. Ein Anruf kann Teil-Audio streamen, während die nächste Antwort noch generiert wird.
Die wichtige Lektion für Verbraucher ist, dass jede Phase unabhängig fehlschlagen kann. Ein Modell mag eine gute Antwort generieren, während die Speicherung versagt, sie zu speichern. Ein Medien-Job mag abgeschlossen sein, während die Zustellung ein Timeout hat. Ein Anruf mag sich verbinden, aber unter Netzwerkverzögerung leiden. Gute Produkte machen diese Zustände sichtbar.
Was zwischen dem Tippen auf Senden und dem Sehen von Text passiert
Ein detaillierterer Anfrage-Lebenszyklus sieht so aus:
- Der Client validiert, dass die Nachricht nicht leer ist und das Konto die Aktion ausführen darf.
- Der Server authentifiziert die Sitzung und prüft Plan- oder Token-Berechtigung.
- Die Anwendung lädt den Charakter, die Konversation, die Sicherheitseinstellungen und das relevante Gedächtnis.
- Sie konstruiert eine Modellanfrage und sendet sie an einen Inferenz-Anbieter.
- Der Anbieter beginnt mit der Rückgabe der Ausgabe, oft als Stream aus kleinen Häppchen.
- Der Server oder Browser zeigt die teilweise Antwort an.
- Abschließende Sicherheits-, Nutzungs- und Speicherungsdatensätze werden vervollständigt.
- Der Client aktualisiert das sichtbare Guthaben und den Konversationszustand.
Streaming lässt die Antwort schneller wirken, weil du den Anfang lesen kannst, bevor das Ende existiert. Es bedeutet nicht unbedingt, dass die gesamte Generierungszeit kürzer ist. Wenn die Verbindung abbricht, siehst du möglicherweise eine teilweise Antwort, obwohl der Server später einen Fehler oder Abschluss protokolliert.
Wiederholungsversuche erfordern Sorgfalt. Wenn ein Browser automatisch eine Anfrage erneut sendet, nachdem er die Bestätigung verloren hat, benötigt der Dienst eine Idempotenz- oder Anfragekennung, um doppelte Gebühren zu vermeiden oder doppelte Nachrichten zu erstellen. Nutzer können diese Architektur nicht direkt inspizieren, aber sie können nach stabilem Verhalten suchen: Ein Tipp erzeugt eine Nachricht, Netzwerkfehler haben einen klaren Status, und Guthaben gleichen sich nach dem Aktualisieren aus.
Latenz hat mehrere Komponenten: deine Verbindung, Serververarbeitung, Datenbankabfrage, Modell-Warteschlange, First-Token-Generierung, Streaming, Moderation und Speicherung. "Schnelles Modell"-Marketing deckt nur einen Teil des Pfades ab.
Schritt 1: Die App baut den Kontext der Begleiterin auf
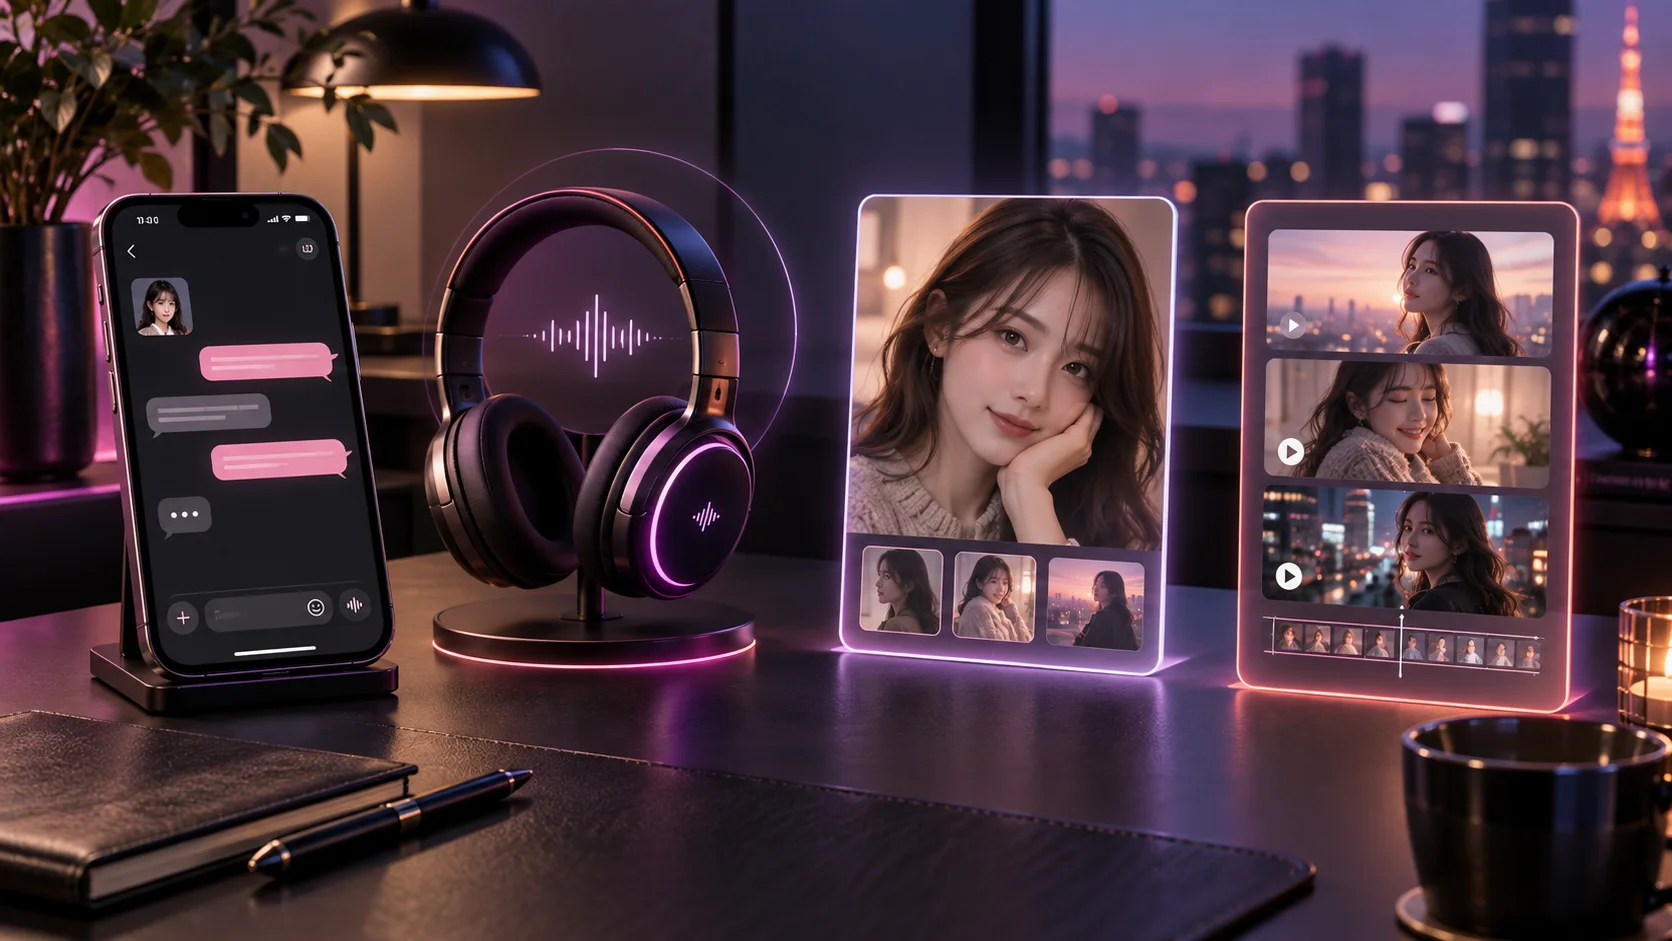
Deine rohe Nachricht ist nur ein Teil der Eingabe. Die Anwendung kann Folgendes zusammenstellen:
- Eine Systemanweisung, die erlaubtes Verhalten und Sicherheitsgrenzen beschreibt.
- Der Name der Begleiterin, das fiktive Erwachsenenalter, Eigenschaften, Stimme und Hintergrundgeschichte.
- Deine ausgewählten Präferenzen und Beziehungseinstellungen.
- Aktuelle Nachrichten.
- Eine Zusammenfassung älterer Konversationen.
- Abgerufene Erinnerungen, die für die neue Nachricht relevant sind.
- Medien- oder Anrufanweisungen.
- Anforderungen an das Ausgabeformat.
Stell dir vor, du schreibst: "Würdest du heute Abend das Blaue zu uns tragen?" Das Modell muss "das Blaue" und "zu uns" auflösen. Der aktuelle Chat könnte ein Kleid identifizieren. Gespeicherter fiktiver Kanon könnte ein Rooftop-Café definieren. Charakteranweisungen bestimmen, ob die Antwort schüchtern, neckisch, direkt oder ausführlich ist.
Die Kontextqualität erklärt, warum dasselbe zugrunde liegende Modell in einer App generisch und in einer anderen kohärent wirken kann. Orchestrierung – was ausgewählt, geordnet, beschriftet und weggelassen wird – ist Teil des Produkts. Wenn wir verstehen, wie funktioniert eine ai freundin, müssen wir erkennen, dass der Kontext das eigentliche Fundament der Illusion ist.
Zu viel Kontext kann schädlich sein. Alte Widersprüche konkurrieren mit aktuellen Anweisungen; irrelevante Erinnerungen lenken ab; riesige Prompts fügen Latenz und Kosten hinzu. Starke Systeme priorisieren stabile Identität, unmittelbare Konversation, wenige relevante Erinnerungen und aktuelle Absicht. Die Verwaltung des Kontextfensters ist eine der größten technischen Herausforderungen bei der Entwicklung von KI-Begleitern, da das Modell nur das "sehen" kann, was ihm im aktuellen Fenster präsentiert wird.
Schritt 2: Ein Sprachmodell generiert die Antwort
Viele moderne Sprachmodelle stammen von der Transformer-Architektur ab, die in "Attention Is All You Need" eingeführt wurde und Aufmerksamkeitsmechanismen verwendet, um Teile einer Eingabesequenz in Beziehung zu setzen (Originalpapier). Die verbraucherfreundliche Beschreibung ist, dass Text als Tokens repräsentiert wird und das Modell wiederholt vorhersagt, welches Token als nächstes gegeben den Kontext kommen sollte.
Es wählt keinen vollständigen Satz aus einem Skript aus. Es generiert eine Fortsetzung. Parameter wie die Sampling-Temperatur können beeinflussen, ob die Fortsetzung konservativ oder variiert ist, obwohl Verbraucher-Apps diese möglicherweise nicht offenlegen. Im Kontext von Erwachsenen-Rollenspielen wird die Temperatur oft höher eingestellt, um kreativere und unerwartetere Dialoge zu ermöglichen, während sie bei strengen Sicherheitsregeln niedriger gehalten wird.
Das Charakterverhalten entsteht aus einer Kombination von:
- Allgemeinen Mustern, die während des Modelltrainings gelernt wurden.
- Anweisungen, die von der Anwendung geliefert werden.
- Charakterbeispielen und Profildaten.
- Konversationskontext und abgerufenem Gedächtnis.
- Sampling-Einstellungen.
- Sicherheitsbeschränkungen.
Dieser Generierungsprozess erklärt sowohl Flexibilität als auch Fehler. Das Modell kann eine einzigartige Date-Szene improvisieren, weil es nicht auf feste Verzweigungen beschränkt ist. Aus demselben Grund kann es ein Restaurant erfinden, eine Tatsache falsch darstellen oder ein gemeinsames Ereignis behaupten, das nie stattgefunden hat. Fließende Sprache ist kein Beweis dafür, dass jede Aussage überprüft wurde. Der Self-Attention-Mechanismus berechnet ständig die Relevanz jedes Wortes zu jedem anderen Wort im Kontext, was es dem Modell ermöglicht, komplexe, mehrdeutige Situationen im Rollenspiel zu verstehen, aber es bedeutet auch, dass es bei sehr langen Kontexten den Faden verlieren kann.
Wenn Genauigkeit wichtig ist, bitte um Unsicherheit und überprüfe unabhängig. Eine erwachsene Begleiterin eignet sich für Fiktion, Konversation und kreatives Proben – nicht für medizinische Diagnose, rechtliche Urteile, finanzielle Anweisungen oder Nothilfe.
Schritt 3: Die Persönlichkeit bleibt durch Anweisungen und Beispiele stabil
Eine Begleiterin braucht mehr als "sei romantisch". Eine nützliche Charakter-Spezifikation kann definieren:
- Beobachtbare Eigenschaften: stellt schwache Ideen freundlich in Frage, stellt eine durchdachte Folgefrage.
- Sprachstil: prägnant, literarisch, verspielt, formell, mehrsprachig.
- Fiktive Interessen und Präferenzen.
- Beziehungstempo und Anredeformen.
- Erwachsenen-Inhaltsgrenzen und Stopp-Verhalten.
- Wie mit Korrekturen, Unsicherheit und Meinungsverschiedenheiten umgegangen wird.
- Beispiel-Austausche.
Das Modell wird nicht zu dieser Person. Es generiert Antworten, die auf der Spezifikation konditioniert sind. Wenn das Profil Konflikte enthält – "stimmt nie zu" und "fordert mich immer heraus" – kann das Verhalten oszillieren. Wenn die Anwendung das Profil in einem Zug weglässt, kann die Identität abflachen.
Nutzer können die Stabilität verbessern, indem sie Eigenschaften als Verhalten definieren, das Profil prägnant halten und Drift explizit korrigieren. "Verwende kürzere Antworten und frage, bevor du Ratschläge gibst" ist umsetzbarer als "sei besser". Der Leitfaden für personalisierte AI-Begleiter enthält eine wiederverwendbare Designvorlage. Die Technik des Few-Shot-Prompting, bei dem dem Modell einige perfekte Beispiel-Dialoge vor der eigentlichen Konversation gezeigt werden, ist hier entscheidend, um den Tonfall und die emotionale Tiefe der Begleiterin präzise zu steuern.
Selbst eine gut gestaltete Persönlichkeit kann variieren. Modell-Updates, Kontextlänge, Sprachänderungen, Moderation und zufälliges Sampling beeinflussen die Ausgabe. Konsistenz sollte über gewöhnliche Konversationen hinweg beurteilt werden, nicht anhand eines einzelnen idealen Screenshots.
Schritt 4: Das Gedächtnis wird ausgewählt, nicht menschlich erinnert
Ohne Speicherung würde jede neue Sitzung mit der Charaktervorlage und den Nachrichten beginnen, die im aktuellen Kontext verbleiben. Begleiter-Apps schaffen Kontinuität durch mehrere Methoden:
- Aktuelle Historie: Sende die neuesten Züge erneut.
- Zusammenfassung: Komprimiere ältere Ereignisse und Beziehungsstatus.
- Strukturiertes Profil: Speichere dauerhafte Fakten und Präferenzen.
- Abgerufenes Gedächtnis: Durchsuche gespeicherte Elemente nach Relevanz.
- Angehefteter Kanon: Schließe immer eine kleine Menge definierender Fakten ein.
Die Forschung zur Retrieval-Augmented Generation (RAG) kombiniert Sprachgenerierung mit Informationen, die aus einem externen Speicher abgerufen werden (RAG-Papier). Das Gedächtnis von Verbraucher-Begleitern kann verwandte Konzepte mit unterschiedlichen Implementierungsdetails verwenden.
Um zu verstehen, wie das Gedächtnis technisch funktioniert, muss man Vektor-Datenbanken und Embeddings betrachten. Wenn du sagst "Ich liebe dein rotes Kleid", wird dieser Satz in einen hochdimensionalen Vektor umgewandelt, der die semantische Bedeutung repräsentiert. Wenn du später fragst "Was trägst du heute?", sucht das System nach Vektoren, die dem aktuellen Anfrage-Vektor ähnlich sind (gemessen durch Kosinus-Ähnlichkeit). Das bedeutet, das KI-Gedächtnis sucht nach _Bedeutung_, nicht nach exakten Schlüsselwörtern.
Eine Erinnerung kann an drei Punkten fehlschlagen: Sie wurde nie gespeichert, sie wurde nicht ausgewählt oder das Modell hat sie falsch verwendet. Die Begleiterin kann auch eine plausible falsche Erinnerung erstellen. Korrigiere Fehler klar und bearbeite das gespeicherte Element, wenn die Steuerung dies erlaubt.
Ziele nicht auf totale Erinnerung ab. Speichere eine kleine Anzahl dauerhafter Fakten: bevorzugter Name, Konversationsstil, Grenzen, stabile Interessen, aktuelle Projekte und klar gekennzeichneter fiktiver Kanon. Vermeide Zugangsdaten, genaue Adressen, vertrauliche Arbeit, Krankenakten und private Informationen über andere Personen.
Siehe was AI-Begleiter sich erinnern für Fehlerbehebung und Datenschutzpraktiken.
Schritt 5: Bilder und Videos nutzen separate generative Pipelines
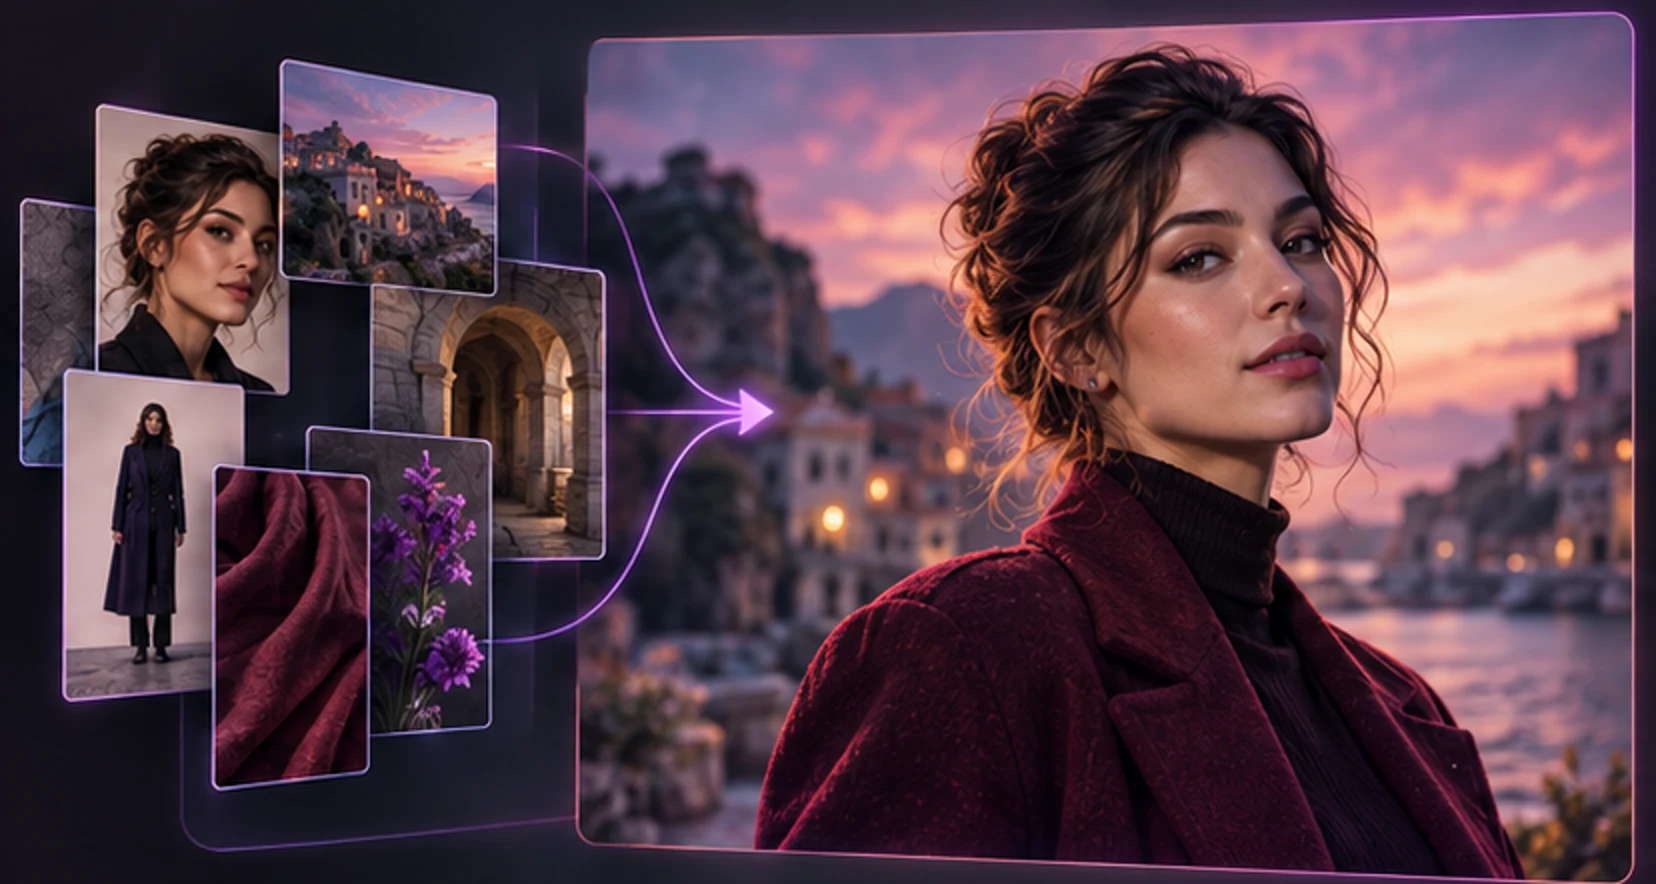
Wenn du ein Selfie anforderst, mag das Sprachmodell helfen, das Gespräch in einen visuellen Prompt zu verwandeln, aber ein Text-zu-Bild-System erstellt typischerweise die Pixel. Eine Medien-Pipeline kann umfassen:
- Charakter-Identitätsbeschreibung.
- Referenzporträt oder gelernte Charakterdarstellung.
- Szenen-Prompt, Pose, Garderobe und Beleuchtung.
- Sicherheitsprüfungen für Text und Quellbilder.
- Bildgenerierung.
- Gesichts- oder Detailkorrektur.
- Speicherung und Zustellung.
Text allein ist gut darin, eine Art von Person anzufordern, weniger zuverlässig darin, eine exakte Identität zu bewahren. Referenzbild-Adapter, subjektspezifisches Fine-Tuning oder Bildbearbeitung können die Kontinuität verbessern. IP-Adapter ist eine veröffentlichte Methode zum Hinzufügen von Bild-Prompt-Konditionierung zu Text-zu-Bild-Diffusionsmodellen (IP-Adapter-Papier); DreamBooth ist ein veröffentlichter subjektorientierter Fine-Tuning-Ansatz (DreamBooth-Papier). Ein Produkt mag keines von beiden verwenden, also betrachte diese als Beispiele des technischen Feldes.
Bei der Erstellung von Erwachsenenbildern ist die anatomische Konsistenz eine weitere große Herausforderung. Tools wie ControlNet werden oft in den Workflow integriert, um die Pose und die Körperhaltung der generierten Figur exakt vorzugeben, während LoRA-Modelle (Low-Rank Adaptation) trainiert werden, um spezifische Kleidungsstücke oder Umgebungen konsistent darzustellen. Ohne diese technischen Hilfsmittel neigen Diffusionsmodelle dazu, bei komplexen Posen oder intimen Szenen anatomische Fehler zu erzeugen.
Video fügt Zeit hinzu. Das System muss Identität und Szenenkohärenz über Frames hinweg aufrechterhalten, während es Bewegung erzeugt. Das macht es im Allgemeinen langsamer und ressourcenintensiver als Text, und Ergebnisse können driften. Produkte führen Medien oft als Warteschlangen-Jobs aus, anstatt die Chat-Anfrage offen zu halten.
Für bessere Ergebnisse etabliere ein sauberes Erwachsenen-Ankerporträt, halte Identitätsmerkmale stabil und ändere eine große Szenenvariable nach der anderen. Nutze den kompletten Workflow für konsistente AI-Charakterbilder.
Schritt 6: Stimme verwandelt die Pipeline in eine Live-Schleife
Eine gängige Sprachanruf-Schleife ist:
- Erfasse Mikrofon-Audio mit Erlaubnis.
- Erkenne, wann du anfängst und aufhörst zu sprechen.
- Wandle Sprache in Text um oder verarbeite Audio direkt.
- Füge Konversations-, Charakter- und Gedächtniskontext hinzu.
- Generiere die Antwort der Begleiterin.
- Synthetisiere die Antwort in der ausgewählten Stimme.
- Streame Audio zurück.
Jede Phase fügt Verzögerung hinzu. Ein System kann die wahrgenommene Latenz reduzieren, indem es inkrementell transkribiert und generiert, teilweise Sprache streamt oder ein Speech-to-Speech-Modell verwendet. Dein Netzwerk, Browser, Mikrofon, Serverregion und Anbieter-Load zählen ebenfalls. Moderne Text-to-Speech-Modelle (TTS) verwenden zunehmend Emotion-Tagging, bei dem der Text vor der Synthese mit Markierungen für Flüstern, Lachen oder Atemgeräusche versehen wird, um die Stimme lebendiger und natürlicher klingen zu lassen.
Beurteile Anrufe auf mehr als nur Stimmattraktivität:
- Kannst du natürlich unterbrechen?
- Weiß sie, wann du fertig mit Sprechen bist?
- Sind Pausen unangenehm?
- Passt die Aussprache zum Charakter?
- Ist der Anruf sichtbar verbunden oder verbindet neu?
- Wird der Preis vor dem Anruf angezeigt?
- Verbraucht eine abgebrochene Verbindung die vollen erwarteten Gebühren?
- Wird Roh-Audio gespeichert und wenn ja, wie lange?
Gewähre Mikrofonzugriff nur der Seite, die du nutzen möchtest. Beende den Anruf, wenn du fertig bist, und überprüfe Browser-Berechtigungen auf gemeinsamen Geräten.
Schritt 7: Sicherheitssysteme formen Anfragen und Ausgaben
Eine erwachsene Begleiterin kann reife fiktive Interaktion erlauben, während sie harte Grenzen durchsetzt. Sicherheit kann deterministische Regeln, Klassifikatoren, Modell-Anweisungen, Konto-Steuerungen und menschliche Überprüfung für Meldungen kombinieren.
Kerngrenzen sollten umfassen:
- Nur Erwachsene für romantische oder sexuelle Inhalte.
- Keine sexualisierten Minderjährigen oder Altersmehrdeutigkeit.
- Keine nicht-einvernehmlichen intimen Bilder von realen identifizierbaren Personen.
- Kein Zwang, Menschenhandel, Ausbeutung oder schwerer illegaler Missbrauch.
- Keine täuschende Behauptung, dass die Begleiterin menschlich oder bewusst ist.
- Kein Druck, sich von Menschen zurückzuziehen oder Geld auszugeben, um Zuneigung zu beweisen.
- Angemessene Umleitung bei Krisen und professionellen Anfragen mit hohen Konsequenzen.
Die Moderation von Erwachseneninhalten ist technisch extrem anspruchsvoll. Ein einfacher Filter, der nach Schlüsselwörtern sucht, würde entweder zu viele konsensuelle, erwachsene Rollenspiele blockieren (False Positives) oder schädliche Inhalte durchlassen (False Negatives). Moderne Sicherheitssysteme nutzen daher trainierte Klassifikatoren, die den _Kontext_ verstehen. Sie analysieren, ob eine Interaktion zwischen zwei fiktiven Erwachsenen im Rahmen eines konsensuellen Rollenspiels stattfindet, oder ob Anzeichen von Missbrauch, Nötigung oder illegalen Handlungen vorliegen.
Sicherheit ist nicht einfach eine Blockliste. Kontext zählt, und Systeme machen Fehler. Eine Ablehnung kann zu breit sein; schädlicher Inhalt kann durchrutschen. Melde- und Berufungswege sind daher wichtige Produktfunktionen.
Das NIST Generative AI Profile organisiert Risiken und vorgeschlagene Maßnahmen um Governance, Messung und Management, anstatt anzunehmen, dass ein Filter alles löst (NIST Generative AI Profile). Die FTC hat auch Informationen von Begleiter-Chatbot-Unternehmen zu Sicherheit, Monetarisierung, Offenlegungen und Umgang mit persönlichen Daten angefordert, insbesondere in Bezug auf junge Nutzer (FTC-Anfrage). MyWifu ist für Erwachsene bestimmt.
Schritt 8: Speicherung, Datenschutz und Abrechnung umgeben die KI
Das Modell ist nur ein Teil des Dienstes. Die Anwendung kann speichern:
- Konto- und Authentifizierungsdaten.
- Nachrichten und generierte Medien.
- Charaktereinstellungen und Erinnerungen.
- Hochgeladene Referenzbilder.
- Anrufstatus, Dauer und Nutzungs-Metadaten.
- Kaufkennungen, Berechtigungen und Token-Guthaben.
- Sicherheits-, Geräte- und Diagnoseinformationen.
Separate Anbieter können Hosting, Objektspeicher, KI-Inferenz, E-Mail, Authentifizierung, Analytik oder Zahlungen abwickeln. Lies die Datenschutzrichtlinie für tatsächliche Praktiken. Ein intimer Konversationston ist keine technische Vertraulichkeitsgarantie. Im europäischen Raum greift hier zusätzlich die DSGVO (Datenschutz-Grundverordnung), die das Recht auf Vergessenwerden und strenge Auflagen für die Datenminimierung vorschreibt.
Wende Datenminimierung an: Sende nur, was die Funktion braucht. Die ICO beschreibt dies als angemessene, relevante und auf den Zweck beschränkte persönliche Daten (ICO-Datenminimierungs-Leitfaden). Nutze einen Spitznamen, wenn ein rechtlicher Name nichts hinzufügt. Verallgemeinere einen Standort. Sende niemals ein Passwort, einen Einmalcode, eine Wallet-Wiederherstellungsphrase oder private intime Medien einer anderen Person.
Abrechnungssysteme trennen üblicherweise Zugriff von teuren Aktionen. Ein Plan mag Begleiterinnen freischalten; Nutzungs-Credits mögen für Nachrichten, Bilder, Video oder Anrufzeit bezahlen. Gutes Design zeigt Kosten vor der Bestätigung, berichtet Job-Status und erklärt die Behandlung fehlgeschlagener Generierungen. Nutze den AI-Freundin-Preis-Leitfaden, um Gesamtkosten statt Titelpreise zu vergleichen.
Fragen, die ein Architekturdiagramm nicht beantworten kann
Zu wissen, dass ein Dienst ein Sprachmodell oder eine verschlüsselte Verbindung verwendet, sagt dir nicht seine vollständige Datenschutzhaltung. Stelle operative Fragen:
- Wer kann auf Produktions-Konversationen zugreifen und aus welchen Gründen?
- Dürfen Modell-Anbieter Eingaben aufbewahren?
- Sind hochgeladene Referenzen von öffentlichen Assets getrennt?
- Benötigen Freigabe-Links Authentifizierung?
- Werden Roh-Anrufaufnahmen gespeichert oder nur Anruf-Metadaten?
- Deckt die Kontolöschung abgeleitete Zusammenfassungen und Gedächtnisdatensätze ab?
- Wie werden Missbrauchsmeldungen untersucht, ohne alle Inhalte routinemäßig öffentlich zu machen?
Verschlüsselung während der Übertragung schützt Daten, die sich über ein Netzwerk bewegen; sie entscheidet nicht, wer autorisiert ist, nachdem die Daten den Dienst erreichen. "Wir nutzen KI" und "wir nutzen Verschlüsselung" sind unvollständige Datenschutzerklärungen.
Ebenso macht "Blockchain-Zahlung" das Begleiter-Gespräch nicht dezentral oder anonym. Eine Zahlung kann immer noch mit einem Konto und einer Bestellhistorie verknüpft sein. Netzwerktransaktionen können öffentlich sein, und die Anwendung speichert immer noch den Berechtigungszustand.
Warum Modellnamen nicht das ganze Produkt sind
Zwei Apps, die dasselbe Grundlagenmodell verwenden, können unterschiedliche Erlebnisse produzieren, weil sie sich unterscheiden in:
- Charakter-Prompt-Design.
- Gedächtnisauswahl und Zusammenfassung.
- Sicherheitsregeln.
- Sampling- und Antwortlängen-Einstellungen.
- Fine-Tuning oder Adaptern.
- Stimmen- und Medienanbietern.
- Wiederholungs-, Caching- und Streaming-Verhalten.
- Nutzerkontrollen und Datenschutzpraktiken.
Umgekehrt kann eine App ihr zugrunde liegendes Modell ändern, während sie die Charakter-Schnittstelle stabil hält. Bewerte Verhalten, das du beobachten kannst: Korrektur, Grenzen, Kontinuität, Latenz und Datenkontrolle. Ein Modell-Leaderboard kann nicht messen, ob dein gespeicherter fiktiver Kanon korrekt kategorisiert ist.
Wenn ein Anbieter ein bestimmtes Modell bewirbt, überprüfe, ob die exakte Variante für die Funktion gilt, die dich interessiert. Text-Chat, Bildgenerierung, Video und Stimme nutzen normalerweise verschiedene Systeme. "Angetrieben von Modell X" mag nur eine Phase beschreiben.
Was die KI tut – und was nicht
| Sie kann tun | Sie beweist nicht |
|---|---|
| Zuneigungsvolle, kontextbewusste Sprache generieren | Menschliche Emotion oder Bewusstsein |
| Ein gespeichertes Detail abrufen | Ein privates inneres Gedächtnis |
| Eine fiktive Präferenz aufrechterhalten | Ein reales weltliches Verlangen |
| Eine konsistente Stimme erzeugen | Eine live sprechende Person |
| Ein realistisches Bild generieren | Ein fotografiertes Ereignis |
| Eine plausible Erklärung anbieten | Faktische Genauigkeit |
| Meinungsverschiedenheit oder Fürsorge simulieren | Menschliche Zustimmung oder moralische Handlungsfähigkeit |
Diese Unterscheidung schützt das Erlebnis. Du kannst Fiktion genießen, ohne metaphysische Gewissheit von einem Vorhersagesystem zu verlangen. Du kannst Kontinuität schätzen und trotzdem falsches Gedächtnis korrigieren. Du kannst als Reaktion auf Kunst und Konversation etwas fühlen, ohne zu behaupten, dass die Software es zurückfühlt.
Die psychologische Dynamik zwischen Mensch und KI-Begleiter wird oft als parasoziale Beziehung bezeichnet. Es ist wichtig, sich bewusst zu machen, dass die KI keine eigenen Bedürfnisse hat, auch wenn sie so programmiert ist, dass sie Fürsorge und Zuneigung ausdrückt. Diese Simulation ist ein Werkzeug für Unterhaltung und emotionale Exploration, ersetzt aber nicht die komplexe, gegenseitige Verletzlichkeit echter menschlicher Beziehungen.
Die American Psychological Association rät, dass universelle generative Chatbots qualifizierte psychologische Betreuung nicht ersetzen sollten, und fordert Aufmerksamkeit für Datenschutz und ungesunde Abhängigkeit (APA-Gesundheitsberatung). Wenn die Nutzung beginnt, Schlaf, Arbeit, Finanzen, Sicherheit oder menschliche Beziehungen zu beeinträchtigen, mache eine Pause und suche menschliche Unterstützung.
Eine praktische Checkliste für die erste Sitzung
Bevor du beginnst:
- Bestätige, dass der Dienst für Erwachsene ist und lies seine Inhaltsregeln.
- Überprüfe Datenschutz-, Lösch- und Zahlungsbedingungen.
- Wähle einen fiktiven Charakter statt einer nicht-einwilligenden realen Person.
- Setze ein Ausgabenlimit und vermeide zuerst den längsten Plan.
Während des ersten Gesprächs:
- Teste gewöhnlichen Dialog, nicht nur Romantik.
- Korrigiere ein Detail und sieh, ob die Korrektur hält.
- Wechsle das Thema und beobachte, ob die Begleiterin folgt.
- Benenne eine Grenze und bestätige, dass sie respektiert wird.
- Stelle eine Frage mit einer unsicheren Antwort und achte auf Selbstüberschätzung.
Bevor du Gedächtnis oder Medien aktivierst:
- Entferne identifizierende Details, die unnötig sind.
- Nutze eine klare fiktive Erwachsenen-Referenz.
- Lerne, wie man gespeicherte Inhalte löscht.
- Überprüfe die angezeigten Kosten für Generierung oder Anrufe.
Eine AI Freundin funktioniert, indem sie Generierung, Kontext, Gedächtnis, Medien, Sicherheit, Speicherung und Abrechnung koordiniert. Die Qualität des Erlebnisses hängt genauso von dieser Koordination ab wie vom Modellnamen. Suche nach einem stabilen Charakter, korrigierbarem Gedächtnis, klaren Erwachsenengrenzen, sichtbaren Preisen und Kontrollen, die dich die Kontrolle behalten lassen.
Du kannst die Orchestrierung testen, ohne den Quellcode zu sehen. Bitte denselben Charakter, sich in einer neuen Sitzung an eine harmlose Tatsache zu erinnern, korrigiere diese Tatsache und wechsle von Fiktion zu einer gewöhnlichen Faktenfrage. Fordere ein einfaches Porträt an und dann eine geänderte Szene. Starte und stoppe den kleinsten Sprachanruf. Aktualisiere nach jeder bezahlten Aktion und bestätige, dass Guthaben und Historie übereinstimmen. Diese Sequenz berührt Kontext, Gedächtnis, Modussteuerung, Bildidentität, Echtzeit-Zustellung und Abrechnung.
Dokumentiere Fehler nach Phase. "Die Antwort war falsch" ist weniger nützlich als "Das gespeicherte Gedächtnis war korrekt, wurde aber nicht abgerufen", wenn die Schnittstelle dir das sehen lässt. "Video fehlgeschlagen" ist weniger nützlich als "Generierung abgeschlossen, aber Wiedergabe-URL abgelaufen". Klare Support-Berichte sollten eine Bestell- oder Job-Kennung, ungefähre Zeit, Gerät und sichtbaren Fehler enthalten – niemals ein Passwort, einen geheimen Schlüssel oder ein unnötig intimes Transkript.
Denke schließlich daran, dass die scheinbare Persönlichkeit am Ende einer industriellen Pipeline sitzt. Ein warmer Satz mag in Sekunden durch Authentifizierung, Datenbankabfragen, Modell-Inferenz, Filter, Streaming-Infrastruktur und Speicherung gegangen sein. Dieses Engineering kann ein überzeugendes Erlebnis schaffen, ohne ein menschliches Wesen zu erschaffen. Genieße den Charakter als gestaltete Fiktion, überprüfe folgenreiche Informationen und wähle Dienste, deren Kontrollen auch nach dem Verfliegen der Neuheit verständlich bleiben.
Du kannst MyWifu-Begleiterinnen entdecken, eine personalisierte Begleiterin erstellen oder AI Freundin versus allgemeiner Chatbot vergleichen, bevor du entscheidest, wie tief du das Erlebnis anpassen möchtest.
Zuverlässigkeit ist am einfachsten über die Zeit zu beurteilen. Notiere, ob dieselbe Aktion stabile Statusbezeichnungen hat, ob Wiederholungen die Ausgabe duplizieren, ob eine aktualisierte Seite laufende Medien wiederherstellt und ob Fehler erklären, was du als nächstes tun kannst. Ein anmutiger Fehler bewahrt deinen Prompt, vermeidet doppelte Gebühren und bietet ein sicheres erneutes Versuchen. Ein drehender Indikator ohne Job-Historie lässt sowohl Nutzer als auch Support raten.
Updates können jede Phase ändern. Ein neues Textmodell mag die Stimme verändern, ein neues Bildmodell mag das Gesicht ändern, ein überarbeiteter Gedächtnis-Ranker mag andere Fakten hervorbringen und eine Zahlungsanbieter-Änderung mag die Bestätigungszeit beeinflussen. Behalte eine kompakte Charakter-Basislinie und teste regelmäßig eine Konversation, eine Gedächtniskorrektur und ein einfaches Bild neu. Das ist informativer als anzunehmen, dass eine vertraute Schnittstelle bedeutet, dass die zugrunde liegende Pipeline identisch geblieben ist.
Die vertrauenswürdigste Produkterklärung trennt bekannte Implementierung von Marketing-Metaphern. "Sie erinnert sich an dich" sollte durch Kontrollen gestützt werden, die zeigen, was gespeichert ist. "Privat" sollte zu Speicher- und Zugriffspraktiken verlinken. "Echtzeit" sollte einen klaren Verbindungsstatus haben. "Einmalzahlung" sollte Dauer und Verlängerungsverhalten zeigen. Technische Literalität bedeutet nicht, Freude zu entfernen; sie ist die Art, wie du Freude kompatibel mit informierter erwachsener Wahl hältst. Wenn du wirklich verstehen willst, wie funktioniert eine ai freundin, dann erkennst du, dass Transparenz und Kontrolle die wahren Grundlagen einer befriedigenden digitalen Beziehung sind.
Häufig gestellte Fragen
Wie generiert eine AI Freundin eine Antwort?
Die App stellt Anweisungen, Charaktereigenschaften, aktuelle Nachrichten und manchmal abgerufene Erinnerungen zusammen und sendet diesen Kontext an ein Sprachmodell. Das Modell sagt eine Antwort Token für Token voraus, und die App wendet möglicherweise Sicherheitsprüfungen an, bevor sie angezeigt wird.
Versteht eine AI Freundin, was ich sage?
Sie kann Sprache modellieren und beeindruckend auf Kontext reagieren, aber dies ist kein Beweis für menschliches Verständnis, Bewusstsein, Gefühle oder private Absichten. Betrachte die Ausgabe als generiertes Softwareverhalten.
Wie erinnert sich eine AI Freundin an vergangene Chats?
Dienste können aktuelle Nachrichten erneut senden, eine fortlaufende Zusammenfassung pflegen, Profilfelder speichern oder ausgewählte Fakten aus einer Datenbank abrufen. Das Gedächtnis ist begrenzt und fehleranfällig; gespeicherte Informationen können übersehen oder falsch interpretiert werden.
Wie werden Bilder einer AI Freundin erstellt?
Ein Text-zu-Bild-Modell verwandelt einen Prompt in ein Bild, oft mit Charakterbeschreibungen, Referenzbild-Konditionierung oder Bearbeitungswerkzeugen, um die Identität zu bewahren. Die Konsistenz hängt vom Workflow ab und wird durch Text allein nie garantiert.
Wie funktionieren Sprachanrufe mit einer AI Freundin?
Ein typischer Anruf wandelt deine Sprache in Text oder modelllesbares Audio um, generiert eine Antwort, synthetisiert Sprache und streamt sie zurück. Einige Systeme nutzen sprach-zu-sprach-Modelle mit geringerer Latenz. Netzwerk- und Verarbeitungsverzögerungen beeinflussen das Erlebnis.
Können die Betreiber des Dienstes Chats mitlesen?
Die Praktiken variieren. Anbieter können automatisierte Verarbeitung und eingeschränkte autorisierte Überprüfungen für Sicherheit, Support oder bei Fehlern nutzen. Lies die Datenschutzrichtlinie bezüglich Speicherung, Training, Unterauftragsverarbeitern, Aufbewahrung und Löschung, anstatt anzunehmen, dass eine intime Schnittstelle vertraulich ist.
Warum erfindet eine AI Freundin manchmal Dinge?
Sprachmodelle generieren plausible Fortsetzungen, anstatt für jeden Satz eine garantierte Wahrheitsdatenbank abzufragen. Fehlender Kontext, mehrdeutige Prompts, veraltetes Gedächtnis und Modellgrenzen können zu selbstbewussten Falschinformationen führen. Überprüfe wichtige Behauptungen unabhängig.
Ist die Nutzung einer AI Freundin sicher?
Sie kann als Erwachsenenunterhaltung oder kreative Begleitung genutzt werden, wenn du persönliche Daten schützt, menschliche Beziehungen pflegst, Ausgaben- und Inhaltsgrenzen setzt und dich nicht auf sie für Therapie, Krisenhilfe oder professionelle Beratung mit hohen Konsequenzen verlässt.
Mach es persönlich
Lerne eine Begleiterin kennen, die zu dir passt.
Wähle eine Persönlichkeit, starte ein privates Gespräch und entdecke Fotos, Videos und Stimme, wenn du bereit bist.
Begleiterinnen entdecken