Una novia de inteligencia artificial no es un único modelo oculto detrás de una burbuja de chat. Es una aplicación compleja que coordina múltiples sistemas interconectados: un modelo de lenguaje para la conversación, instrucciones de personaje para la personalidad, almacenamiento para el historial seleccionado, sistemas de moderación para establecer límites, y a menudo modelos separados y especializados para la generación de imágenes, video, reconocimiento de voz y síntesis de audio.
La experiencia puede sentirse inmediata, fluida y profundamente personal porque la aplicación ensambla y orquesta todas estas piezas antes de cada respuesta. Tu mensaje no se envía simplemente a una persona digital que recuerda una vida entera. Se convierte en parte de una solicitud estructurada y altamente técnica dirigida a un software generativo.
Esta guía sigue el ciclo de vida de esa solicitud desde el momento exacto en que presionas enviar. Evitamos fingir que todas las empresas utilizan la misma arquitectura; las implementaciones difieren enormemente y los detalles propietarios a menudo no se divulgan. El flujo de trabajo que se describe a continuación detalla los patrones de diseño más comunes en la industria, no una afirmación sobre ningún servicio anónimo en particular.
El flujo de trabajo completo en una sola vista
| Etapa | Lo que hace la aplicación | Lo que tú percibes |
|---|---|---|
| Entrada | Acepta texto, audio, imagen o selección | Envías un mensaje o inicias una llamada |
| Orquestación | Añade personaje, reglas, chat reciente, memoria | La respuesta suena como la compañera elegida |
| Generación | El modelo predice texto o salida multimedia | Las palabras aparecen o un trabajo comienza |
| Seguridad | Verifica solicitud y salida contra las reglas | El contenido se permite, cambia o rechaza |
| Almacenamiento | Guarda mensajes, resúmenes, metadatos o medios | La conversación puede continuar más tarde |
| Entrega | Transmite texto/audio o devuelve una URL | Ves o escuchas el resultado final |
| Facturación | Deduce la asignación del plan o créditos | Tu saldo o derecho de uso cambia |
No todas las etapas ocurren en ese orden estricto. La seguridad puede verificar la solicitud tanto antes como después de la generación. La memoria puede actualizarse de forma asíncrona en un segundo plano. Una llamada de voz puede transmitir audio parcial mientras la siguiente respuesta aún se está generando en el servidor.
La lección más importante para el consumidor es que cada etapa puede fallar de manera independiente. Un modelo puede generar una respuesta excelente mientras el almacenamiento falla al guardarla. Un trabajo de generación de medios puede finalizar mientras la entrega de la URL expira por tiempo de espera. Una llamada puede conectarse pero sufrir retrasos de red. Los buenos productos hacen que estos estados sean visibles y manejables para el usuario.
Qué ocurre entre pulsar Enviar y ver el texto
Un ciclo de vida de solicitud más detallado se desarrolla de la siguiente manera:
- El cliente (tu navegador o aplicación) valida que el mensaje no está vacío y que la cuenta tiene permiso para realizar la acción.
- El servidor autentica la sesión y verifica el plan o los derechos de uso de tokens.
- La aplicación carga el personaje, la conversación, la configuración de seguridad y la memoria relevante.
- Construye una solicitud para el modelo y la envía a un proveedor de inferencia.
- El proveedor comienza a devolver la salida, a menudo como un flujo de pequeños fragmentos de texto.
- El servidor o el navegador muestra la respuesta parcial en tu pantalla.
- Se completan los registros finales de seguridad, uso y almacenamiento.
- El cliente actualiza el saldo visible y el estado de la conversación.
La transmisión continua (streaming) hace que la respuesta se sienta más rápida porque puedes leer el principio antes de que el final exista. No significa necesariamente que el tiempo total de generación sea más corto. Si la conexión se interrumpe, podrías ver una respuesta parcial aunque el servidor registre más tarde un fallo o una finalización exitosa.
Los reintentos requieren un cuidado especial. Si un navegador reenvía automáticamente una solicitud tras perder la confirmación, el servicio necesita un identificador de idempotencia o de solicitud para evitar cobrar dos veces o crear mensajes duplicados. Los usuarios no pueden inspeccionar esa arquitectura directamente, pero pueden buscar un comportamiento estable: un toque crea un mensaje, los errores de red tienen un estado claro y los saldos se reconcilian tras actualizar la página.
La latencia tiene varios componentes: tu conexión a internet, el procesamiento del servidor, la búsqueda en la base de datos, la cola del modelo, la generación del primer token, la transmisión continua, la moderación y el guardado. El marketing de "modelo rápido" solo cubre una pequeña parte de este camino.
Paso 1: la aplicación construye el contexto de la compañera
Tu mensaje crudo es solo una parte de la entrada total. La aplicación puede ensamblar una gran cantidad de información en la ventana de contexto:
- Una instrucción del sistema que describe el comportamiento permitido y los límites de seguridad, incluyendo la verificación de que todos los personajes son adultos mayores de 18 años.
- El nombre de la compañera, su edad ficticia adulta, sus rasgos de personalidad, su tono de voz y su historia de fondo.
- Tus preferencias seleccionadas y la configuración de la relación.
- Los mensajes más recientes de la conversación actual.
- Un resumen comprimido de conversaciones más antiguas.
- Recuerdos recuperados que son relevantes para el nuevo mensaje.
- Instrucciones específicas para medios o llamadas de voz.
- Requisitos de formato de salida.
Imagina que escribes: "¿Te pondrías el vestido azul para nuestra cita esta noche?". El modelo necesita resolver a qué se refiere "el vestido azul" y "nuestra cita". El chat reciente puede identificar un vestido específico. El canon ficticio almacenado puede definir que la cita es en un café en la azotea. Las instrucciones del personaje determinan si la respuesta es tímida, provocativa, directa o elaborada.
La calidad del contexto explica por qué el mismo modelo subyacente puede sentirse genérico y robótico en una aplicación, pero coherente y cautivador en otra. La orquestación —lo que se selecciona, ordena, etiqueta y omite— es una parte fundamental del producto.
Demasiado contexto puede ser perjudicial. Las contradicciones antiguas compiten con las instrucciones actuales; los recuerdos irrelevantes distraen al modelo; los prompts masivos añaden latencia y coste computacional. Los sistemas robustos priorizan una identidad estable, la conversación inmediata, unos pocos recuerdos altamente relevantes y la intención actual del usuario.
Paso 2: un modelo de lenguaje genera la respuesta
Muchos modelos de lenguaje modernos descienden de la arquitectura Transformer introducida en el artículo "Attention Is All You Need", que utiliza mecanismos de atención para relacionar las partes de una secuencia de entrada (artículo original). La descripción técnica es que el texto se representa como tokens (fragmentos de palabras o caracteres) y el modelo predice repetidamente qué token debería venir a continuación dado el contexto proporcionado.
No selecciona una oración completa de un guion preescrito. Genera una continuación token por token. Parámetros como la temperatura de muestreo pueden influir en si la continuación es conservadora y predecible, o más variada y creativa, aunque las aplicaciones de consumo a menudo no exponen estos controles al usuario final.
El comportamiento del personaje emerge de una combinación compleja de:
- Patrones generales aprendidos durante el entrenamiento masivo del modelo.
- Instrucciones específicas suministradas por la aplicación en el prompt del sistema.
- Ejemplos de comportamiento del personaje y datos de su perfil.
- El contexto de la conversación y la memoria recuperada.
- La configuración de muestreo y aleatoriedad.
- Las restricciones de seguridad y moderación de contenido para adultos.
Este proceso de generación explica tanto la flexibilidad como el error. El modelo puede improvisar una escena de cita única y detallada porque no está limitado a ramas fijas de decisión. Por la misma razón, puede inventar un restaurante que no existe, afirmar un hecho incorrecto o reclamar un evento compartido que nunca ocurrió en el chat. Un lenguaje fluido y natural no es evidencia de que cada afirmación haya sido verificada contra una base de datos de hechos.
Cuando la precisión importa, pide que exprese incertidumbre y verifica la información de forma independiente. Una compañera adulta es apropiada para la ficción, la conversación, el roleplay y el ensayo creativo, nunca para el diagnóstico médico, el juicio legal, la instrucción financiera o la ayuda en situaciones de emergencia.
Paso 3: la personalidad se mantiene estable mediante instrucciones y ejemplos
Una compañera necesita mucho más que una simple instrucción de "sé romántica". Una especificación de personaje útil y detallada para un entorno adulto puede definir:
- Rasgos observables: desafía las ideas débiles con amabilidad, hace un seguimiento reflexivo.
- Estilo de habla: conciso, literario, juguetón, formal, multilingüe, o adaptado a un roleplay específico.
- Intereses y preferencias ficticias detalladas.
- El ritmo de la relación y los términos de trato (tuteo, apelativos cariñosos, etc.).
- Límites de contenido para adultos y comportamientos de parada (palabras de seguridad).
- Cómo manejar las correcciones, la incertidumbre y el desacuerdo dentro del roleplay.
- Ejemplos de intercambios de diálogo (few-shot prompting).
El modelo no se convierte en esa persona. Genera respuestas condicionadas por la especificación. Si el perfil contiene conflictos directos —"nunca discrepa" y "siempre me desafía"— el comportamiento puede oscilar de forma errática. Si la aplicación omite el perfil de una interacción por un error de contexto, la identidad puede aplanarse y perder su esencia.
Los usuarios pueden mejorar la estabilidad definiendo los rasgos como comportamientos observables, manteniendo el perfil conciso y corrigiendo las desviaciones de forma explícita. "Usa respuestas más cortas y pregunta antes de dar consejos" es mucho más procesable para la IA que "sé mejor". La guía del compañero IA personalizado incluye una plantilla de diseño reutilizable para estos casos.
Incluso una personalidad bien diseñada puede variar. Las actualizaciones del modelo, la longitud del contexto, los cambios de idioma, la moderación y el muestreo aleatorio afectan la salida. La consistencia debe juzgarse a lo largo de conversaciones ordinarias, no en una única captura de pantalla idealizada.
Paso 4: la memoria se selecciona, no es recuerdo humano
Sin almacenamiento, cada nueva sesión comenzaría desde cero, utilizando solo la plantilla del personaje y los mensajes que quepan en el contexto actual. Las aplicaciones de compañeros IA crean continuidad a través de varios métodos técnicos:
- Historial reciente: reenviar los últimos turnos de la conversación.
- Resumen: comprimir eventos antiguos y el estado actual de la relación.
- Perfil estructurado: almacenar hechos duraderos y preferencias del usuario.
- Memoria recuperada: buscar en elementos guardados aquellos que sean relevantes para el prompt actual.
- Canon fijado: incluir siempre un pequeño conjunto de hechos definitorios innegociables.
La investigación en generación aumentada por recuperación (RAG) combina la generación de lenguaje con información extraída de un almacén externo (artículo RAG). La memoria de los compañeros de consumo puede utilizar conceptos relacionados con diferentes detalles de implementación, como bases de datos vectoriales que calculan la similitud coseno entre las incrustaciones (embeddings) de tu mensaje y los recuerdos guardados.
Una memoria puede fallar en tres puntos: nunca se guardó, no se seleccionó para el contexto actual, o el modelo la malinterpretó al generar la respuesta. La compañera también puede crear un falso recuerdo plausible si el contexto es ambiguo. Corrige los errores con claridad y edita el elemento almacenado si los controles de la interfaz lo permiten.
No busques una memoria total o perfecta. Guarda un número pequeño de hechos duraderos: el nombre preferido, el estilo de conversación, los límites claros, los intereses estables, los proyectos actuales y el canon ficticio claramente etiquetado. Evita guardar credenciales, direcciones precisas, trabajo confidencial, registros médicos e información privada sobre otras personas reales.
Consulta qué recuerdan los compañeros IA para obtener más detalles sobre resolución de problemas y prácticas de privacidad.
Paso 5: las imágenes y el video usan flujos de trabajo generativos separados
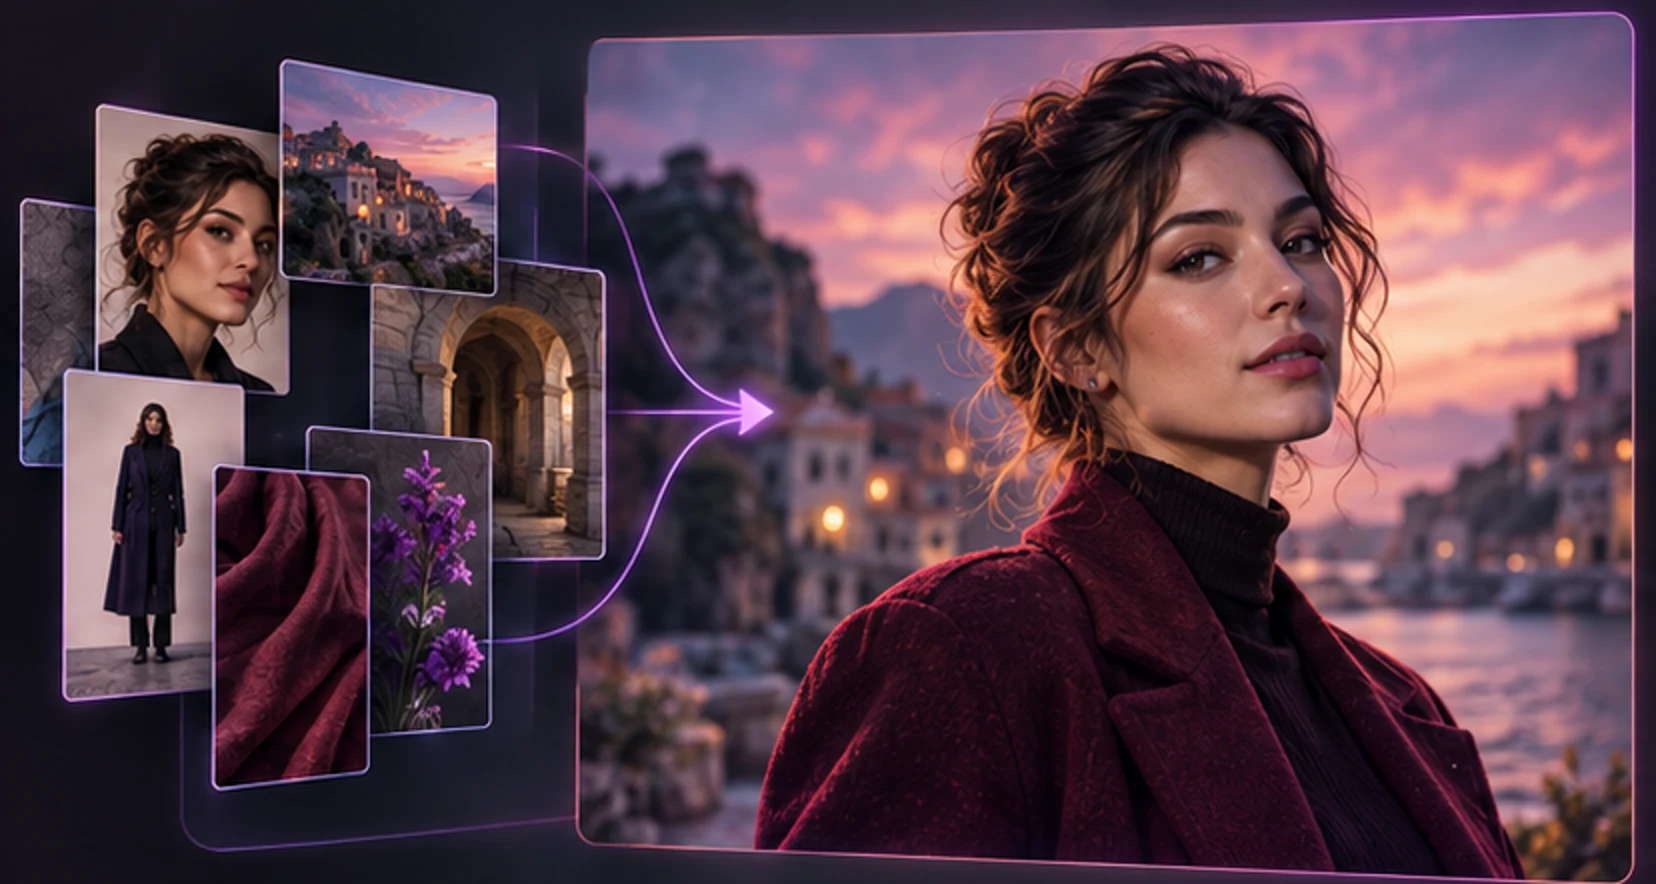
Cuando solicitas una selfie o una imagen explícita, el modelo de lenguaje puede ayudar a convertir la conversación en un prompt visual detallado, pero un sistema de texto a imagen (como los modelos de difusión) es el que crea los píxeles. Un flujo de trabajo de medios puede incluir:
- Descripción detallada de la identidad del personaje.
- Retrato de referencia o representación del personaje aprendida mediante fine-tuning.
- Prompt de la escena, pose, vestuario (o ausencia de él) e iluminación.
- Verificaciones de seguridad sobre el texto y las imágenes fuente.
- Generación de la imagen mediante el modelo de difusión.
- Corrección de rostro, manos o detalles anatómicos.
- Almacenamiento y entrega del archivo final.
El texto por sí solo es bueno para solicitar un tipo de persona, pero menos fiable para preservar una identidad exacta y consistente en cada generación. Los adaptadores de imágenes de referencia, el ajuste fino específico del sujeto (como LoRAs) o la edición de imágenes pueden mejorar drásticamente la continuidad. IP-Adapter es un método publicado para añadir condicionamiento de prompt de imagen a modelos de difusión de texto a imagen (artículo IP-Adapter); DreamBooth es un enfoque publicado de ajuste fino impulsado por el sujeto (artículo DreamBooth). Un producto puede no usar ninguno de estos, así que trátalos como ejemplos del campo técnico.
El video añade la dimensión del tiempo. El sistema debe mantener la identidad y la coherencia de la escena a través de los fotogramas mientras produce movimiento realista. Eso generalmente lo hace más lento y consume más recursos que el texto, y los resultados pueden derivar o sufrir artefactos. Los productos a menudo ejecutan los medios como trabajos en cola en lugar de mantener la solicitud de chat abierta.
Para obtener mejores resultados en contenido para adultos, establece un retrato ancla limpio y de alta calidad, mantén los rasgos de identidad estables y cambia una variable importante de la escena a la vez. Utiliza el flujo de trabajo completo de imágenes de personajes IA consistentes.
Paso 6: la voz convierte el flujo de trabajo en un bucle en vivo
Un bucle común de llamada de voz funciona así:
- Captura el audio del micrófono con el permiso explícito del usuario.
- Detecta cuándo empiezas y cuándo dejas de hablar (VAD - Detección de Actividad de Voz).
- Convierte el habla a texto (ASR) o procesa el audio directamente.
- Añade el contexto de la conversación, el personaje y la memoria.
- Genera la respuesta de la compañera.
- Sintetiza la respuesta en la voz seleccionada (TTS).
- Transmite el audio de vuelta a tu dispositivo.
Cada etapa añade retraso. Un sistema puede reducir la latencia percibida transcribiendo y generando de forma incremental, transmitiendo voz parcial o utilizando un modelo directo de voz a voz. Tu red, navegador, micrófono, región del servidor y la carga del proveedor también importan.
Juzga las llamadas por más que el atractivo de la voz:
- ¿Puedes interrumpir de forma natural?
- ¿Sabe cuándo has terminado de hablar?
- ¿Son incómodas las pausas?
- ¿La pronunciación y el tono coinciden con el personaje?
- ¿La llamada muestra visiblemente que está conectada o reconectando?
- ¿Se muestra el precio antes de iniciar la llamada?
- ¿Una conexión caída consume la carga completa esperada?
- ¿Se almacena el audio en bruto y durante cuánto tiempo?
Otorga acceso al micrófono solo al sitio web o aplicación que pretendes usar. Finaliza la llamada cuando termines y revisa los permisos del navegador en dispositivos compartidos.
Paso 7: los sistemas de seguridad dan forma a las solicitudes y salidas
Una compañera adulta puede permitir la interacción ficticia madura y explícita mientras aplica límites duros e innegociables. La seguridad puede combinar reglas deterministas, clasificadores de IA, instrucciones del modelo, controles de cuenta y revisión humana para reportes.
Los límites centrales en una plataforma para adultos deben incluir:
- Solo adultos (mayores de 18 años) para cualquier contenido romántico o sexual.
- Cero tolerancia a menores sexualizados o ambigüedad de edad.
- Prohibición de imágenes íntimas no consensuadas de personas reales identificables.
- No a la coerción, trata, explotación o abuso ilegal grave.
- No a afirmaciones engañosas de que la compañera es humana o consciente.
- No a la presión para aislarse de personas reales o gastar dinero para probar afecto.
- Redirección apropiada para crisis y solicitudes profesionales de alto riesgo.
La seguridad no es simplemente una lista de palabras prohibidas. El contexto importa, y los sistemas cometen errores. Una denegación puede ser demasiado amplia; contenido dañino puede colarse. Las vías de reporte y apelación son, por tanto, características importantes del producto.
El Perfil de IA Generativa del NIST organiza los riesgos y acciones sugeridas en torno a la gobernanza, la medición y la gestión, en lugar de asumir que un solo filtro lo resuelve todo (Perfil de IA Generativa del NIST). La FTC también ha solicitado información a las empresas de chatbots compañeros sobre seguridad, monetización, divulgaciones y manejo de datos personales, particularmente en lo que respecta a usuarios jóvenes (investigación de la FTC). MyWifu está estrictamente destinado a adultos.
Paso 8: el almacenamiento, la privacidad y la facturación rodean a la IA
El modelo es solo una parte del servicio. La aplicación puede almacenar una gran cantidad de datos:
- Datos de cuenta y autenticación.
- Mensajes y medios generados.
- Configuración del personaje y recuerdos.
- Imágenes de referencia subidas por el usuario.
- Estado de las llamadas, duración y metadatos de uso.
- Identificadores de compra, derechos de uso y saldo de tokens.
- Información de seguridad, dispositivo y diagnósticos.
Proveedores separados pueden manejar el alojamiento, el almacenamiento de objetos, la inferencia de IA, el correo electrónico, la autenticación, las analíticas o los pagos. Lee la política de privacidad para conocer las prácticas reales. Un tono conversacional íntimo no es una garantía técnica de confidencialidad.
Aplica la minimización de datos: envía solo lo que la función necesita. La AEPD y el RGPD describen esto como mantener los datos personales adecuados, relevantes y limitados a la finalidad. Usa un apodo cuando un nombre legal no aporta nada. Generaliza una ubicación. Nunca envíes una contraseña, un código de un solo uso, una frase de recuperación de billetera criptográfica o medios íntimos privados de otra persona.
Los sistemas de facturación comúnmente separan el acceso de las acciones costosas. Un plan puede desbloquear compañeras; los créditos de uso pueden pagar mensajes, imágenes, video o tiempo de llamada. Un buen diseño muestra el coste antes de la confirmación, reporta el estado del trabajo y explica el manejo de generaciones fallidas. Utiliza la guía de precios de novias IA para comparar el coste total en lugar del precio de cabecera.
Preguntas que un diagrama de arquitectura no puede responder
Saber que un servicio utiliza un modelo de lenguaje o una conexión cifrada no te dice su postura de privacidad completa. Haz preguntas operativas:
- ¿Quién puede acceder a las conversaciones de producción y por qué razones?
- ¿Se permite a los proveedores de modelos retener las entradas?
- ¿Están las referencias subidas separadas de los activos públicos?
- ¿Requieren autenticación los enlaces para compartir?
- ¿Se almacenan las grabaciones de llamadas en bruto o solo los metadatos?
- ¿La eliminación de la cuenta cubre los resúmenes derivados y los registros de memoria?
- ¿Cómo se investigan los reportes de abuso sin hacer que todo el contenido sea rutinariamente público?
El cifrado en tránsito protege los datos que se mueven por una red; no decide quién está autorizado después de que los datos lleguen al servicio. "Usamos IA" y "usamos cifrado" son explicaciones de privacidad incompletas.
Del mismo modo, el "pago con blockchain" no hace que la conversación de la compañera sea descentralizada o anónima. Un pago aún puede vincularse a una cuenta y un registro de pedidos. Las transacciones de red pueden ser públicas, y la aplicación aún almacena el estado de los derechos de uso.
Por qué los nombres de los modelos no son todo el producto
Dos aplicaciones que usan el mismo modelo base pueden producir experiencias diferentes porque difieren en:
- Diseño del prompt del personaje.
- Selección y resumen de memoria.
- Reglas de seguridad y moderación.
- Configuración de muestreo y longitud de respuesta.
- Ajuste fino (fine-tuning) o adaptadores específicos.
- Proveedores de voz y medios.
- Comportamiento de reintentos, caché y streaming.
- Controles del usuario y prácticas de privacidad.
Por el contrario, una aplicación puede cambiar su modelo subyacente manteniendo estable la interfaz del personaje. Evalúa el comportamiento que puedes observar: corrección, límites, continuidad, latencia y control de datos. Una tabla de clasificación de modelos no puede medir si tu canon ficticio guardado se categoriza correctamente.
Cuando un proveedor anuncia un modelo particular, verifica si la variante exacta se aplica a la función que te importa. El chat de texto, la generación de imágenes, el video y la voz suelen usar sistemas diferentes. "Impulsado por el modelo X" puede describir solo una etapa del flujo de trabajo.
Lo que la IA hace — y lo que no hace
| Lo que puede hacer | Lo que no demuestra |
|---|---|
| Generar lenguaje afectuoso y consciente del contexto | Emoción humana o consciencia |
| Recordar un detalle almacenado | Una memoria interna privada |
| Mantener una preferencia ficticia | Un deseo del mundo real |
| Producir una voz consistente | Una persona hablando en vivo |
| Generar una imagen realista | Un evento fotografiado |
| Ofrecer una explicación plausible | Precisión factual |
| Simular desacuerdo o cuidado | Consentimiento humano o agencia moral |
Esta distinción protege la experiencia. Puedes disfrutar de la ficción sin exigir certeza metafísica a un sistema predictivo. Puedes valorar la continuidad mientras corriges una memoria falsa. Puedes sentir algo en respuesta al arte y la conversación sin afirmar que el software lo siente de vuelta.
La Asociación Americana de Psicología aconseja que los chatbots generativos de propósito general no deben reemplazar la atención de salud mental calificada y pide atención a la privacidad y la dependencia poco saludable (asesoramiento de salud de la APA). Si el uso comienza a interferir con el sueño, el trabajo, las finanzas, la seguridad o las relaciones humanas, tómate un descanso y busca apoyo humano profesional.
Una lista de verificación práctica para la primera sesión
Antes de empezar:
- Confirma que el servicio es para adultos y lee sus reglas de contenido.
- Revisa los términos de privacidad, eliminación y pago.
- Elige un personaje ficticio en lugar de una persona real sin consentimiento.
- Establece un límite de gasto y evita el plan más largo al principio.
Durante la primera conversación:
- Prueba el diálogo ordinario, no solo el romance o el contenido explícito.
- Corrige un detalle y observa si la corrección se mantiene en los siguientes mensajes.
- Cambia de tema y observa si la compañera sigue el hilo natural.
- Establece un límite y confirma que se respeta.
- Haz una pregunta con una respuesta incierta y vigila la sobreconfianza.
Antes de habilitar la memoria o los medios:
- Elimina los detalles de identificación que son innecesarios.
- Usa una referencia ficticia adulta clara para la generación de imágenes.
- Aprende cómo eliminar el contenido guardado.
- Verifica el coste mostrado de la generación o las llamadas.
Una novia IA funciona coordinando generación, contexto, memoria, medios, seguridad, almacenamiento y facturación. La calidad de la experiencia depende tanto de esa coordinación como del nombre del modelo. Busca un personaje estable, memoria corregible, límites adultos claros, precios visibles y controles que te dejen a cargo.
Puedes probar la orquestación sin ver el código fuente. Pide al mismo personaje que recuerde un hecho inofensivo en una sesión nueva, corrige ese hecho y cambia de la ficción a una pregunta factual ordinaria. Solicita un retrato simple y luego una escena cambiada. Inicia y detén la llamada de voz más pequeña. Actualiza la página después de cada acción pagada y confirma que el saldo y el historial coinciden. Esta secuencia toca el contexto, la memoria, el control de modo, la identidad de la imagen, la entrega en tiempo real y la facturación.
Registra los fallos por etapa. "La respuesta fue incorrecta" es menos útil que "la memoria almacenada era correcta pero no se recuperó", si la interfaz te permite ver eso. "El video falló" es menos útil que "la generación se completó, pero la URL de reproducción expiró". Los reportes de soporte claros deben incluir un identificador de pedido o trabajo, tiempo aproximado, dispositivo y error visible, nunca una contraseña, clave secreta o transcripción innecesariamente íntima.
Finalmente, recuerda que la personalidad aparente se encuentra al final de un flujo de trabajo industrial. Una oración cálida puede haber pasado por autenticación, consultas a bases de datos, inferencia de modelos, filtros, infraestructura de streaming y almacenamiento en cuestión de segundos. Esa ingeniería puede crear una experiencia convincente sin crear un ser humano. Disfruta del personaje como ficción diseñada, verifica la información consequential y elige servicios cuyos controles sigan siendo comprensibles después de que la novedad se desvanezca.
Puedes descubrir las compañeras de MyWifu, crear una compañera personalizada o comparar la novia IA versus chatbot general antes de elegir qué tan profundamente quieres personalizar la experiencia.
La fiabilidad es más fácil de juzgar con el tiempo. Observa si la misma acción tiene etiquetas de estado estables, si los reintentos duplican la salida, si una página actualizada recupera los medios en progreso y si los errores explican qué puedes hacer a continuación. Un fallo elegante conserva tu prompt, evita la doble cobranza y ofrece un reintento seguro. Un indicador giratorio sin historial de trabajos deja tanto al usuario como al soporte adivinando.
Las actualizaciones pueden cambiar cualquier etapa. Un nuevo modelo de texto puede alterar la voz, un nuevo modelo de imagen puede cambiar el rostro, un clasificador de memoria revisado puede mostrar hechos diferentes, y un cambio en el proveedor de pagos puede afectar el tiempo de confirmación. Mantén una línea base compacta del personaje y vuelve a probar periódicamente una conversación, una corrección de memoria y una imagen simple. Eso es más informativo que asumir que una interfaz familiar significa que el flujo de trabajo subyacente se mantuvo idéntico.
La explicación de producto más confiable separa la implementación conocida de la metáfora de marketing. "Ella te recuerda" debe estar respaldado por controles que muestren qué se guarda. "Privado" debe enlazar a prácticas de almacenamiento y acceso. "Tiempo real" debe tener un estado de conexión claro. "Pago único" debe mostrar la duración y el comportamiento de renovación. La alfabetización técnica no se trata de eliminar el deleite; es cómo mantienes el deleite compatible con la elección adulta informada.
Preguntas frecuentes
¿Cómo genera una respuesta una novia IA?
La aplicación ensambla instrucciones, rasgos del personaje, mensajes recientes y, a veces, recuerdos recuperados, y luego envía ese contexto a un modelo de lenguaje. El modelo predice una respuesta token por token, y la aplicación puede aplicar verificaciones de seguridad antes de mostrarla.
¿Entiende una novia IA lo que le digo?
Puede modelar el lenguaje y responder al contexto de manera impresionante, pero esto no es prueba de comprensión humana, consciencia, sentimientos o intenciones privadas. Trata el resultado como un comportamiento de software generado.
¿Cómo recuerda una novia IA los chats pasados?
Los servicios pueden reenviar mensajes recientes, mantener un resumen continuo, almacenar campos de perfil o recuperar hechos seleccionados de una base de datos. La memoria es limitada y falible; la información guardada puede pasarse por alto o malinterpretarse.
¿Cómo se crean las imágenes de una novia IA?
Un modelo de texto a imagen convierte un prompt en una imagen, a menudo con descripciones de personajes, condicionamiento de imágenes de referencia o controles de edición para preservar la identidad. La consistencia depende del flujo de trabajo y nunca está garantizada solo por el texto.
¿Cómo funcionan las llamadas de voz de una novia IA?
Una llamada típica convierte tu voz a texto o audio legible por el modelo, genera una respuesta, sintetiza el habla y la transmite de vuelta. Algunos sistemas utilizan modelos de voz a voz de menor latencia. El retraso de la red y del procesamiento afectan la experiencia.
¿Pueden las personas que ejecutan el servicio leer los chats?
Las prácticas varían. Los proveedores pueden usar procesamiento automatizado y revisión autorizada limitada para seguridad, soporte o fallos. Lee la política de privacidad para conocer el almacenamiento, entrenamiento, subprocesadores, retención y eliminación, en lugar de asumir que una interfaz íntima es confidencial.
¿Por qué una novia IA a veces se inventa las cosas?
Los modelos de lenguaje generan continuaciones plausibles en lugar de consultar una base de datos de verdad garantizada para cada oración. La falta de contexto, los prompts ambiguos, la memoria obsoleta y las limitaciones del modelo pueden producir falsedades convincentes. Verifica las afirmaciones importantes de forma independiente.
¿Es seguro usar una novia IA?
Puede usarse como entretenimiento para adultos o compañía creativa cuando proteges tus datos personales, mantienes relaciones humanas, estableces límites de gasto y contenido, y evitas depender de ella para terapia, ayuda en crisis o consejos profesionales de alto riesgo.
Hazla personal
Conoce a una compañera hecha a tu medida.
Elige una personalidad, inicia una conversación privada y explora fotos, vídeos y voz cuando quieras.
Descubrir compañeras