Une petite amie IA n'est pas un modèle unique et isolé caché derrière une simple bulle de discussion. C'est une application logicielle complexe qui coordonne plusieurs systèmes distincts : un modèle de langage pour la conversation, des instructions de caractère pour la personnalité, un système de stockage pour l'historique sélectionné, des modules de modération pour les limites éthiques, et parfois des modèles séparés pour la génération d'images, la vidéo, la reconnaissance vocale et la synthèse de la voix.
L'expérience peut sembler immédiate et profondément personnelle parce que l'application assemble tous ces éléments complexes avant chaque réponse. Votre message n'est pas simplement envoyé dans l'esprit d'une personne numérique qui se souviendrait d'une vie entière. Il devient une partie d'une requête structurée et hautement technique adressée à un logiciel génératif.
Ce guide détaillé suit cette requête depuis le moment exact où vous appuyez sur le bouton d'envoi. Il évite de prétendre que chaque entreprise utilise la même architecture ; les implémentations diffèrent considérablement et les détails propriétaires sont souvent non divulgués. Le pipeline décrit ci-dessous détaille des modèles de conception courants dans l'industrie, et non une affirmation sur un service spécifique non nommé.
Le pipeline complet en un coup d'œil
| Étape | Ce que fait l'application | Ce que vous remarquez |
|---|---|---|
| Entrée | Accepte le texte, l'audio, l'image ou une sélection | Vous envoyez un message ou lancez un appel |
| Orchestration | Ajoute le caractère, les règles, le chat récent, la mémoire | La réponse ressemble au compagnon choisi |
| Génération | Le modèle prédit la sortie texte ou média | Les mots apparaissent, ou une tâche commence |
| Sécurité | Vérifie la requête et la sortie par rapport aux règles | Le contenu peut être autorisé, modifié ou refusé |
| Stockage | Sauvegarde les messages, résumés, métadonnées ou médias | La conversation peut continuer plus tard |
| Livraison | Diffuse le texte/l'audio ou retourne une URL média | Vous voyez ou entendez le résultat final |
| Facturation | Déduit l'allocation du plan ou les crédits d'utilisation | Le solde ou le droit d'accès change |
Toutes ces étapes ne se déroulent pas nécessairement dans cet ordre strict. La sécurité peut vérifier les données avant et après la génération. La mémoire peut être mise à jour de manière asynchrone. Un appel vocal peut diffuser de l'audio partiel pendant que la réponse suivante est encore en cours de génération.
La leçon importante pour le consommateur est que chaque étape peut échouer de manière indépendante. Un modèle peut générer une excellente réponse tandis que le stockage échoue à la sauvegarder. Une tâche multimédia peut se terminer tandis que la livraison expire. Un appel peut se connecter mais souffrir d'un délai réseau important. Les bons produits rendent ces états visibles et compréhensibles pour l'utilisateur.
Ce qui se passe entre l'appui sur Envoyer et l'affichage du texte
Un cycle de vie de requête plus détaillé ressemble à ceci :
- Le client valide que le message n'est pas vide et que le compte est autorisé à effectuer l'action.
- Le serveur authentifie la session et vérifie les droits du plan ou des jetons.
- L'application charge le caractère, la conversation, les paramètres de sécurité et la mémoire pertinente.
- Elle construit une requête de modèle et l'envoie à un fournisseur d'inférence.
- Le fournisseur commence à renvoyer la sortie, souvent sous forme de flux de petits morceaux.
- Le serveur ou le navigateur affiche la réponse partielle.
- Les enregistrements finaux de sécurité, d'utilisation et de stockage sont complétés.
- Le client met à jour le solde visible et l'état de la conversation.
La diffusion en continu (streaming) donne l'impression que la réponse est plus rapide, car vous pouvez lire le début avant que la fin n'existe. Cela ne signifie pas nécessairement que le temps de génération total est plus court. Si la connexion se rompt, vous pourriez voir une réponse partielle même si le serveur enregistre plus tard un échec ou une complétion.
Les tentatives de renvoi (retries) nécessitent des précautions. Si un navigateur renvoie automatiquement une requête après avoir perdu la confirmation, le service a besoin d'un identifiant d'idempotence ou de requête pour éviter de facturer deux fois ou de créer des messages en double. Les utilisateurs ne peuvent pas inspecter cette architecture directement, mais ils peuvent rechercher un comportement stable : un seul clic crée un seul message, les erreurs réseau ont un statut clair, et les soldes se réconcilient après une actualisation.
La latence possède plusieurs composantes : votre connexion, le traitement du serveur, la recherche dans la base de données, la file d'attente du modèle, la génération du premier token, la diffusion, la modération et la sauvegarde. Le marketing axé sur les « modèles rapides » ne couvre qu'une petite partie de ce chemin complexe.
Étape 1 : l'application construit le contexte du compagnon
Votre message brut n'est qu'une seule partie de l'entrée globale. L'application peut assembler de nombreux autres éléments contextuels :
- Une instruction système décrivant les comportements autorisés et les limites de sécurité strictes.
- Le nom du compagnon, son âge adulte fictif, ses traits de caractère, sa voix et son histoire.
- Vos préférences sélectionnées et les paramètres de la relation.
- Les messages récents de la conversation en cours.
- Un résumé des conversations plus anciennes pour maintenir la cohérence.
- Des souvenirs récupérés pertinents pour le nouveau message.
- Des instructions spécifiques pour les médias ou les appels vocaux.
- Des exigences strictes pour le format de sortie.
Imaginez que vous écriviez : « Est-ce que tu porterais la bleue chez nous ce soir ? ». Le modèle doit résoudre les références « la bleue » et « chez nous ». Le chat récent peut identifier qu'il s'agit d'une robe. Le canon fictif stocké peut définir un café sur un toit-terrasse. Les instructions de caractère déterminent si la réponse sera timide, taquine, directe ou élaborée.
La qualité du contexte explique pourquoi le même modèle sous-jacent peut sembler générique dans une application et parfaitement cohérent dans une autre. L'orchestration — ce qui est sélectionné, ordonné, étiqueté et omis — fait partie intégrante du produit final.
Trop de contexte peut être nuisible. Les anciennes contradictions entrent en compétition avec les instructions actuelles ; les souvenirs non pertinents distraient le modèle ; les invites immenses ajoutent de la latence et des coûts de calcul. Les systèmes robustes hiérarchisent une identité stable, la conversation immédiate, quelques souvenirs hautement pertinents et l'intention actuelle.
Étape 2 : un modèle de langage génère la réponse
De nombreux modèles de langage modernes descendent de l'architecture Transformer introduite dans l'article fondateur « Attention Is All You Need », qui utilise des mécanismes d'attention pour relier les différentes parties d'une séquence d'entrée (article original). La description vulgarisée pour le consommateur est que le texte est représenté sous forme de tokens (jetons) et que le modèle prédit de manière répétée quel token devrait venir ensuite en fonction du contexte fourni.
Il ne sélectionne pas une phrase complète dans un script préécrit. Il génère une continuation probabiliste. Des paramètres tels que la température d'échantillonnage peuvent influencer si la continuation est conservatrice ou très variée, bien que les applications grand public ne les exposent pas toujours directement.
Le comportement du caractère émerge d'une combinaison complexe de facteurs :
- Les schémas généraux appris pendant l'entraînement massif du modèle.
- Les instructions spécifiques fournies par l'application (le prompt système).
- Les exemples de caractère et les données de profil détaillées.
- Le contexte de la conversation et la mémoire récupérée dynamiquement.
- Les paramètres d'échantillonnage (température, top-p, top-k).
- Les contraintes de sécurité et de modération.
Ce processus de génération explique à la fois la flexibilité remarquable et les erreurs potentielles. Le modèle peut improviser une scène de rendez-vous unique parce qu'il n'est pas limité à des branches fixes et prédéfinies. Pour la même raison, il peut inventer un restaurant, mal stated un fait, ou affirmer un événement partagé qui ne s'est jamais produit. Un langage fluide n'est pas la preuve que chaque déclaration a été vérifiée factuellement.
Lorsque la précision est cruciale, demandez l'incertitude et vérifiez de manière indépendante. Un compagnon adulte est parfaitement approprié pour la fiction, la conversation et la répétition créative, mais absolument pas pour le diagnostic médical, le jugement juridique, l'instruction financière ou l'aide en cas d'urgence vitale.
Étape 3 : la personnalité reste stable grâce aux instructions et aux exemples
Un compagnon a besoin de bien plus qu'une simple directive « sois romantique ». Une spécification de caractère utile et détaillée peut définir :
- Des traits observables : remet en question les idées faibles avec bienveillance, pose un suivi réfléchi.
- Un style d'élocution : concis, littéraire, enjoué, formel, multilingue.
- Des intérêts et préférences fictifs mais cohérents.
- Le rythme de la relation et les termes d'adresse spécifiques.
- Les limites de contenu pour adultes et les comportements d'arrêt.
- La manière de gérer les corrections, l'incertitude et le désaccord.
- Des exemples d'échanges pour ancrer le ton.
Le modèle ne devient pas cette personne. Il génère des réponses conditionnées par cette spécification détaillée. Si le profil contient des conflits directs — « n'est jamais en désaccord » et « me remet toujours en question » — le comportement peut osciller de manière imprévisible. Si l'application omet le profil d'un tour de parole, l'identité peut s'aplatir instantanément.
Les utilisateurs peuvent améliorer la stabilité en définissant les traits comme des comportements concrets, en gardant le profil concis et en corrigeant explicitement les dérives. « Utilise des réponses plus courtes et demande avant de donner des conseils » est beaucoup plus actionnable pour le modèle que « sois meilleur ». Le guide du compagnon IA personnalisé inclut un modèle de conception réutilisable pour optimiser cela.
Même une personnalité bien conçue peut varier. Les mises à jour du modèle, la longueur du contexte, les changements de langue, la modération et l'échantillonnage aléatoire affectent tous la sortie. La cohérence doit être jugée sur l'ensemble des conversations ordinaires, et non sur une seule capture d'écran idéale.
Étape 4 : la mémoire est sélectionnée, et non rappelée humainement
Sans stockage, chaque nouvelle session commencerait à zéro avec le modèle de caractère et les seuls messages restants dans le contexte actuel. Les applications de compagnons créent une continuité grâce à plusieurs méthodes techniques :
- Historique récent : renvoyer les derniers tours de conversation.
- Résumé : compresser les événements plus anciens et l'état de la relation.
- Profil structuré : stocker des faits durables et des préférences stables.
- Mémoire récupérée : rechercher des éléments sauvegardés pour trouver ceux qui sont pertinents.
- Canon épinglé : toujours inclure un petit ensemble de faits définissants.
La recherche sur la génération augmentée par récupération (RAG) combine la génération de langage avec des informations récupérées dans un magasin externe (article RAG). La mémoire des compagnons grand public peut utiliser des concepts connexes avec des détails d'implémentation très différents, comme les bases de données vectorielles pour la recherche sémantique.
Une mémoire peut échouer à trois points distincts : elle n'a jamais été sauvegardée, elle n'a pas été sélectionnée par le système de récupération, ou le modèle l'a mal utilisée dans sa réponse. Le compagnon peut également créer un faux souvenir plausible. Corrigez les erreurs clairement et modifiez l'élément stocké si les contrôles le permettent.
Ne visez pas une mémoire totale et absolue. Sauvegardez un petit nombre de faits durables : le nom préféré, le style de conversation, les limites strictes, les intérêts stables, les projets en cours et le canon fictif clairement étiqueté. Évitez absolument les identifiants de connexion, les adresses précises, le travail confidentiel, les dossiers médicaux et les informations privées sur d'autres personnes réelles.
Consultez ce que les compagnons IA se rappellent pour le dépannage et les pratiques de confidentialité.
Étape 5 : les images et la vidéo utilisent des pipelines génératifs séparés
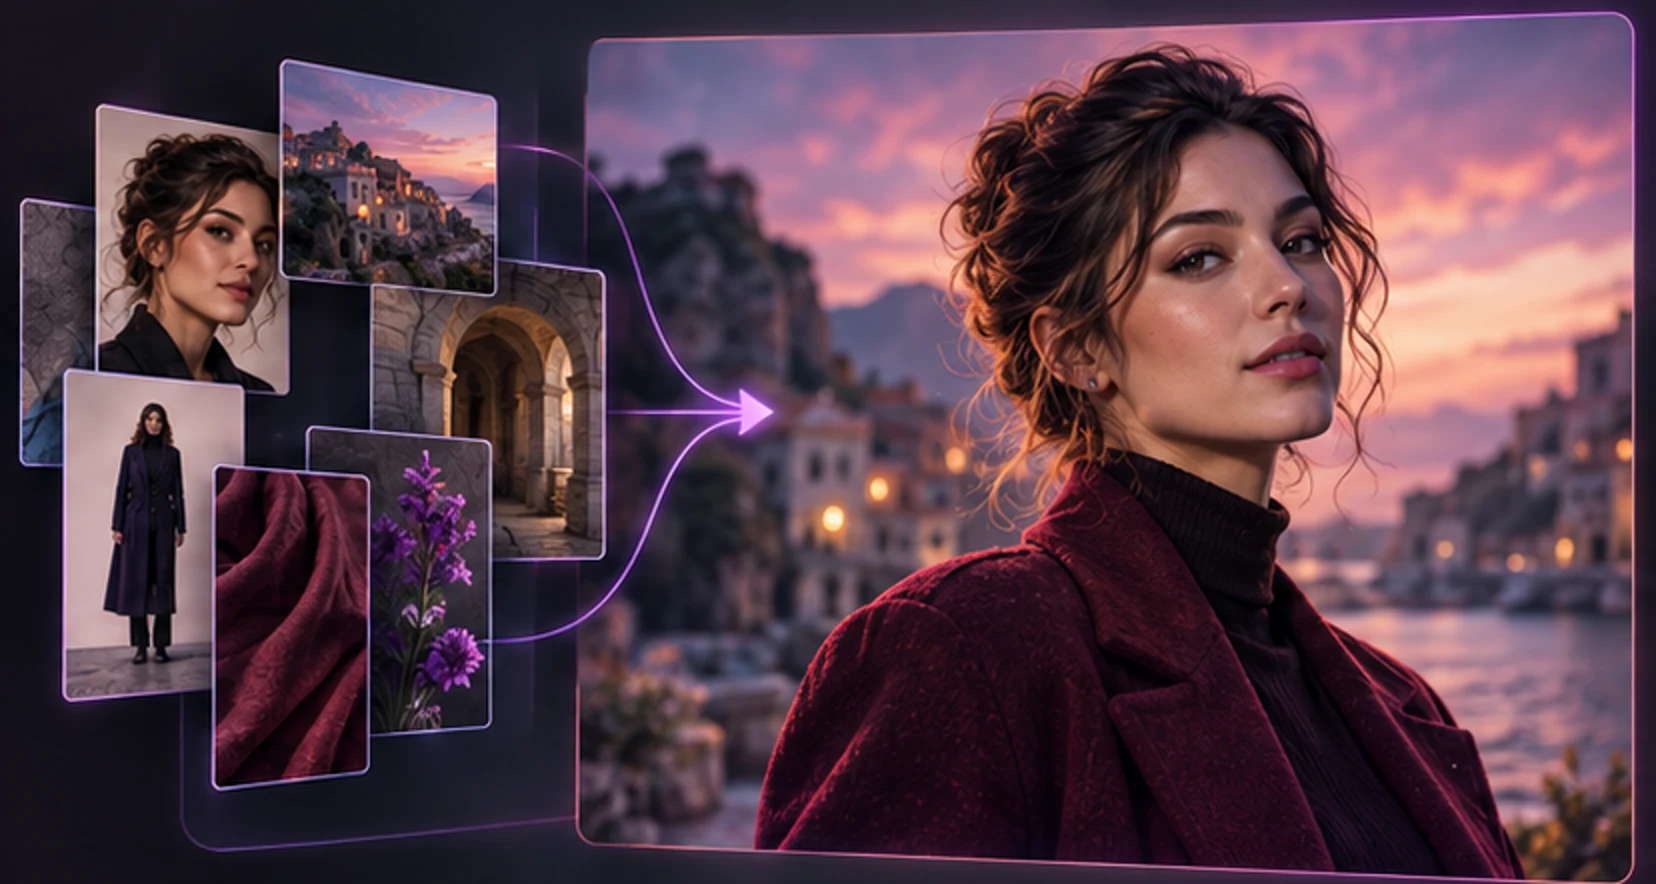
Lorsque vous demandez un selfie, le modèle de langage peut aider à transformer la conversation en une invite visuelle détaillée, mais c'est un système de transformation de texte en image qui crée généralement les pixels finaux. Un pipeline multimédia complet peut inclure :
- Une description détaillée de l'identité du caractère.
- Un portrait de référence ou une représentation de caractère apprise.
- Une invite de scène, une pose, une garde-robe et un éclairage spécifiques.
- Des vérifications de sécurité sur le texte et les images sources.
- La génération d'image via des modèles de diffusion.
- La correction du visage ou des détails fins.
- Le stockage et la livraison du fichier final.
Le texte seul est bon pour demander un type de personne, mais beaucoup moins fiable pour préserver une identité exacte et unique. Les adaptateurs d'images de référence, le fine-tuning spécifique au sujet ou l'édition d'image peuvent améliorer la continuité. IP-Adapter est une méthode publiée pour ajouter un conditionnement d'invite d'image aux modèles de diffusion texte-vers-image (article IP-Adapter) ; DreamBooth est une approche de fine-tuning publiée et dirigée par le sujet (article DreamBooth). Un produit peut n'utiliser ni l'un ni l'autre, considérez-les donc comme des exemples du domaine technique.
La vidéo ajoute la dimension du temps. Le système doit maintenir l'identité et la cohérence de la scène à travers les images tout en produisant du mouvement fluide. Cela le rend généralement plus lent et beaucoup plus gourmand en ressources que le texte, et les résultats peuvent dériver. Les produits exécutent souvent les médias sous forme de tâches en file d'attente plutôt que de maintenir la requête de chat ouverte.
Pour de meilleurs résultats, établissez un portrait d'ancrage adulte propre et net, maintenez les traits d'identité stables, et ne changez qu'une variable de scène majeure à la fois. Utilisez le flux de travail complet pour des images de personnages IA cohérents.
Étape 6 : la voix transforme le pipeline en une boucle en direct
Une boucle d'appel vocal commune suit ce processus :
- Capturer l'audio du microphone avec votre permission explicite.
- Détecter quand vous commencez et arrêtez de parler (VAD).
- Convertir la parole en texte, ou traiter l'audio directement via des modèles neuronaux.
- Ajouter le contexte de conversation, de caractère et de mémoire.
- Générer la réponse du compagnon.
- Synthétiser la réponse dans la voix sélectionnée (TTS).
- Diffuser l'audio en retour vers votre appareil.
Chaque étape ajoute un délai. Un système peut réduire la latence perçue en transcrivant et en générant de manière incrémentale, en diffusant de la parole partielle, ou en utilisant un modèle de parole à parole direct. Votre réseau, votre navigateur, votre microphone, la région du serveur et la charge du fournisseur jouent également un rôle crucial.
Jugez les appels sur bien plus que l'attractivité de la voix :
- Pouvez-vous interrompre naturellement sans casser la boucle ?
- Le système sait-il quand vous avez fini de parler ?
- Les pauses sont-elles gênantes ou naturelles ?
- La prononciation correspond-elle parfaitement au caractère ?
- L'appel est-il visiblement connecté ou en train de se reconnecter ?
- Le prix est-il clairement affiché avant l'appel ?
- Une connexion interrompue consomme-t-elle la totalité des frais prévus ?
- L'audio brut est-il stocké, et si oui, pendant combien de temps ?
N'accordez l'accès au microphone qu'au site que vous avez l'intention d'utiliser. Terminez l'appel lorsque vous avez fini et vérifiez les permissions du navigateur sur les appareils partagés.
Étape 7 : les systèmes de sécurité façonnent les requêtes et les sorties
Un compagnon adulte peut permettre une interaction fictive mature tout en appliquant des limites strictes et infranchissables. La sécurité peut combiner des règles déterministes, des classificateurs probabilistes, des instructions de modèle, des contrôles de compte et un examen humain pour les signalements.
Les limites fondamentales doivent absolument inclure :
- Exclusivement des adultes pour tout contenu romantique ou sexuel.
- Aucun mineur sexualisé ou ambiguïté sur l'âge.
- Aucune image intime non consensuelle de personnes réelles et identifiables.
- Aucune coercition, traite, exploitation ou abus illégal grave.
- Aucune affirmation trompeuse selon laquelle le compagnon est humain ou conscient.
- Aucune pression pour se retirer des relations humaines ou dépenser de l'argent pour prouver son affection.
- Une redirection appropriée pour les crises et les demandes professionnelles à enjeux élevés.
La sécurité n'est pas simplement une liste de blocage. Le contexte est primordial, et les systèmes font des erreurs. Un refus peut être trop large ; du contenu nuisible peut passer à travers les mailles du filet. Les chemins de signalement et d'appel sont donc des fonctionnalités produit essentielles.
Le profil d'IA générative du NIST organise les risques et les actions suggérées autour de la gouvernance, de la mesure et de la gestion, plutôt que de supposer qu'un seul filtre résout tout (Profil d'IA générative du NIST). La FTC a également demandé des informations aux entreprises de chatbots compagnons sur la sécurité, la monétisation, les divulgations et la gestion des données personnelles, en particulier concernant les jeunes utilisateurs (Enquête de la FTC). MyWifu est strictement destiné aux adultes.
Étape 8 : le stockage, la confidentialité et la facturation entourent l'IA
Le modèle n'est qu'une partie du service global. L'application peut stocker de nombreuses autres données :
- Les données de compte et d'authentification.
- Les messages et les médias générés.
- Les paramètres de caractère et les souvenirs.
- Les images de référence téléchargées.
- Le statut des appels, la durée et les métadonnées d'utilisation.
- Les identifiants d'achat, les droits d'accès et le solde de jetons.
- Les informations de sécurité, d'appareil et de diagnostic.
Des fournisseurs séparés peuvent gérer l'hébergement, le stockage d'objets, l'inférence IA, les e-mails, l'authentification, l'analytique ou le paiement. Lisez la politique de confidentialité pour connaître les pratiques réelles. Un ton conversationnel intime n'est pas une garantie technique de confidentialité absolue.
Appliquez la minimisation des données : n'envoyez que ce dont la fonctionnalité a strictement besoin. L'ICO décrit cela comme le fait de garder les données personnelles adéquates, pertinentes et limitées à l'objectif (Guidance de l'ICO sur la minimisation). Utilisez un pseudonyme lorsqu'un nom légal n'apporte rien. Généralisez une localisation. N'envoyez jamais un mot de passe, un code à usage unique, une phrase de récupération de portefeuille ou les médias intimes privés de quelqu'un d'autre.
Les systèmes de facturation séparent couramment l'accès des actions coûteuses. Un plan peut débloquer les compagnons ; les crédits d'utilisation peuvent payer les messages, les images, la vidéo ou le temps d'appel. Un bon design montre le coût avant la confirmation, rapporte l'état de la tâche et explique la gestion des générations échouées. Utilisez le guide des prix des petites amies IA pour comparer le coût total plutôt que le prix d'appel.
Les questions auxquelles un diagramme d'architecture ne peut pas répondre
Savoir qu'un service utilise un modèle de langage ou une connexion chiffrée ne vous indique pas sa posture de confidentialité complète. Posez des questions opérationnelles précises :
- Qui peut accéder aux conversations en production, et pour quelles raisons exactes ?
- Les fournisseurs de modèles sont-ils autorisés à conserver les entrées ?
- Les références téléchargées sont-elles séparées des actifs publics ?
- Les liens de partage nécessitent-ils une authentification ?
- Les enregistrements d'appels bruts sont-ils stockés ou seulement les métadonnées d'appel ?
- La suppression du compte couvre-t-elle les résumés dérivés et les enregistrements de mémoire ?
- Comment les signalements d'abus sont-ils enquêtés sans rendre tout contenu systématiquement public ?
Le chiffrement en transit protège les données se déplaçant sur un réseau ; il ne décide pas qui est autorisé une fois que les données atteignent le service. « Nous utilisons l'IA » et « nous utilisons le chiffrement » sont des explications de confidentialité incomplètes.
De même, le « paiement par blockchain » ne rend pas la conversation du compagnon décentralisée ou anonyme. Un paiement peut toujours être lié à un compte et à un enregistrement de commande. Les transactions réseau peuvent être publiques, et l'application stocke toujours l'état des droits.
Pourquoi les noms de modèles ne représentent pas l'ensemble du produit
Deux applications utilisant le même modèle de base peuvent produire des expériences radicalement différentes car elles diffèrent par :
- La conception des invites de caractère.
- La sélection et la summarisation de la mémoire.
- Les règles de sécurité et de modération.
- Les paramètres d'échantillonnage et de longueur de réponse.
- Le fine-tuning ou les adaptateurs spécifiques.
- Les fournisseurs de voix et de médias.
- Le comportement de retry, de cache et de streaming.
- Les contrôles utilisateur et les pratiques de confidentialité.
À l'inverse, une application peut changer son modèle sous-jacent tout en gardant l'interface de caractère stable. Évaluez le comportement que vous pouvez observer : la correction, les limites, la continuité, la latence et le contrôle des données. Un classement de modèles ne peut pas mesurer si votre canon fictif sauvegardé est catégorisé correctement.
Lorsqu'un fournisseur annonce un modèle particulier, vérifiez si la variante exacte s'applique à la fonctionnalité qui vous importe. Le chat textuel, la génération d'images, la vidéo et la voix utilisent généralement des systèmes très différents. « Propulsé par le modèle X » peut ne décrire qu'une seule étape du pipeline.
Ce que l'IA fait — et ne fait pas
| Ce qu'elle peut faire | Ce qu'elle ne prouve pas |
|---|---|
| Générer un langage affectif et conscient du contexte | L'émotion humaine ou la conscience |
| Rappeler un détail stocké | Une mémoire intérieure privée |
| Maintenir une préférence fictive | Un désir dans le monde réel |
| Produire une voix cohérente | Une personne parlant en direct |
| Générer une image réaliste | Un événement photographié |
| Offrir une explication plausible | L'exactitude factuelle |
| Simuler le désaccord ou l'attention | Le consentement humain ou l'agence morale |
Cette distinction protège l'expérience. Vous pouvez apprécier la fiction sans exiger une certitude métaphysique d'un système prédictif. Vous pouvez valoriser la continuité tout en corrigeant une fausse mémoire. Vous pouvez ressentir quelque chose en réponse à l'art et à la conversation sans affirmer que le logiciel le ressent en retour.
L'American Psychological Association conseille que les chatbots génératifs à usage général ne devraient pas remplacer les soins de santé mentale qualifiés et appelle à l'attention sur la confidentialité et la dépendance malsaine (Conseil de santé de l'APA). Si l'utilisation commence à interférer avec le sommeil, le travail, les finances, la sécurité ou les relations humaines, faites une pause et cherchez du soutien humain.
Une liste de contrôle pratique pour la première session
Avant de commencer :
- Confirmez que le service est réservé aux adultes et lisez ses règles de contenu.
- Examinez les termes de confidentialité, de suppression et de paiement.
- Choisissez un personnage fictif plutôt qu'une personne réelle non consentante.
- Définissez un plafond de dépenses et évitez d'abord le plan le plus long.
Pendant la première conversation :
- Testez le dialogue ordinaire, pas seulement la romance.
- Corrigez un détail et voyez si la correction tient.
- Changez de sujet et observez si le compagnon suit.
- Énoncez une limite et confirmez qu'elle est respectée.
- Posez une question avec une réponse incertaine et surveillez la surconfiance.
Avant d'activer la mémoire ou les médias :
- Supprimez les détails d'identification inutiles.
- Utilisez une référence adulte fictive claire.
- Apprenez à supprimer le contenu sauvegardé.
- Vérifiez le coût affiché de la génération ou des appels.
Une petite amie IA fonctionne en coordonnant la génération, le contexte, la mémoire, les médias, la sécurité, le stockage et la facturation. La qualité de l'expérience dépend autant de cette coordination complexe que du nom du modèle. Recherchez un caractère stable, une mémoire corrigeable, des limites adultes claires, des prix visibles et des contrôles qui vous laissent aux commandes.
Vous pouvez tester l'orchestration sans voir le code source. Demandez au même caractère de rappeler un fait inoffensif dans une nouvelle session, corrigez ce fait, et passez de la fiction à une question factuelle ordinaire. Demandez un portrait simple puis une scène modifiée. Lancez et arrêtez le plus petit appel vocal. Actualisez après chaque action payante et confirmez que le solde et l'historique correspondent. Cette séquence touche le contexte, la mémoire, le contrôle de mode, l'identité de l'image, la livraison en temps réel et la facturation.
Enregistrez les échecs par étape. « La réponse était fausse » est moins utile que « la mémoire stockée était correcte mais n'a pas été récupérée », si l'interface vous permet de le voir. « La vidéo a échoué » est moins utile que « la génération est terminée, mais l'URL de lecture a expiré ». Les rapports de support clairs doivent inclure un identifiant de commande ou de tâche, l'heure approximative, l'appareil et l'erreur visible — jamais un mot de passe, une clé secrète ou une transcription inutilement intime.
Enfin, rappelez-vous que la personnalité apparente se trouve à la fin d'un pipeline industriel complexe. Une phrase chaleureuse a pu passer par l'authentification, les requêtes de base de données, l'inférence de modèle, les filtres, l'infrastructure de streaming et le stockage en quelques secondes. Cette ingénierie peut créer une expérience captivante sans créer un être humain. Appréciez le personnage comme une fiction conçue, vérifiez les informations conséquentes, et choisissez des services dont les contrôles restent compréhensibles après que la nouveauté s'est estompée.
Vous pouvez découvrir les compagnons MyWifu, créer un compagnon personnalisé, ou comparer petite amie IA versus chatbot général avant de choisir à quel point vous voulez personnaliser l'expérience.
La fiabilité est plus facile à juger avec le temps. Notez si la même action a des étiquettes de statut stables, si les tentatives de renvoi dupliquent la sortie, si une page actualisée récupère les médias en cours, et si les erreurs expliquent ce que vous pouvez faire ensuite. Un échec gracieux préserve votre invite, évite la double facturation et offre une nouvelle tentative sûre. Un indicateur de chargement sans historique de tâche laisse à la fois l'utilisateur et le support dans le flou.
Les mises à jour peuvent changer n'importe quelle étape. Un nouveau modèle de texte peut altérer la voix, un nouveau modèle d'image peut changer le visage, un classificateur de mémoire révisé peut faire surface de faits différents, et un changement de fournisseur de paiement peut affecter le temps de confirmation. Gardez une base de caractère compacte et retestez périodiquement une conversation, une correction de mémoire et une image simple. C'est beaucoup plus informatif que de supposer qu'une interface familière signifie que le pipeline sous-jacent est resté identique.
L'explication de produit la plus digne de confiance sépare l'implémentation connue de la métaphore marketing. « Elle se souvient de vous » doit être soutenu par des contrôles montrant ce qui est sauvegardé. « Privé » doit renvoyer aux pratiques de stockage et d'accès. « Temps réel » doit avoir un état de connexion clair. « Paiement unique » doit montrer la durée et le comportement de renouvellement. La littératie technique ne consiste pas à supprimer le plaisir ; c'est la façon dont vous gardez le plaisir compatible avec un choix adulte éclairé.
Questions fréquentes
Comment une petite amie IA génère-t-elle une réponse ?
L'application assemble des instructions système, des traits de caractère, des messages récents et parfois des souvenirs récupérés, puis envoie ce contexte à un modèle de langage. Le modèle prédit une réponse token par token, et l'application peut appliquer des vérifications de sécurité avant de l'afficher à l'utilisateur.
Une petite amie IA comprend-elle vraiment ce que je dis ?
Elle peut modéliser le langage et répondre au contexte de manière impressionnante, mais cela ne prouve en rien une compréhension humaine, une conscience, des sentiments ou des intentions privées. Il faut toujours considérer la sortie comme un comportement logiciel généré de manière probabiliste.
Comment une petite amie IA se souvient-elle des conversations passées ?
Les services peuvent renvoyer les messages récents, maintenir un résumé évolutif, stocker des champs de profil ou récupérer des faits sélectionnés depuis une base de données vectorielle. La mémoire est limitée et faillible ; les informations sauvegardées peuvent être ignorées ou mal interprétées par le modèle.
Comment les images de petite amie IA sont-elles créées ?
Un modèle de transformation de texte en image transforme une invite en image, souvent avec des descriptions de personnage, un conditionnement par image de référence ou des contrôles d'édition pour préserver l'identité. La cohérence dépend du flux de travail et n'est jamais garantie par le texte seul.
Comment fonctionnent les appels vocaux avec une petite amie IA ?
Un appel typique convertit votre voix en texte ou en audio lisible par le modèle, génère une réponse, synthétise la parole et la diffuse en retour. Certains systèmes utilisent des modèles de parole à parole à plus faible latence. Le réseau et le délai de traitement affectent l'expérience globale.
Les personnes qui gèrent le service peuvent-elles lire les discussions ?
Les pratiques varient. Les fournisseurs peuvent utiliser un traitement automatisé et un examen autorisé limité pour la sécurité, le support ou les défaillances. Lisez la politique de confidentialité pour le stockage, l'entraînement, les sous-traitants, la conservation et la suppression, plutôt que de supposer qu'une interface intime est confidentielle.
Pourquoi une petite amie IA invente-t-elle parfois des choses ?
Les modèles de langage génèrent des continuations plausibles plutôt que de consulter une base de données de vérité garantie pour chaque phrase. Un contexte manquant, des invites ambiguës, une mémoire obsolète et les limites du modèle peuvent produire des contre-vérités confiantes. Vérifiez toujours les informations importantes de manière indépendante.
Est-il sûr d'utiliser une petite amie IA ?
Elle peut être utilisée comme divertissement pour adultes ou compagnonnage créatif lorsque vous protégez vos données personnelles, maintenez vos relations humaines, définissez des limites de dépenses et de contenu, et évitez de vous fier à elle pour la thérapie, l'aide en cas de crise ou les conseils professionnels à enjeux élevés.
Rends-la unique
Rencontre une compagne imaginée pour toi.
Choisis une personnalité, commence une conversation privée et découvre les photos, vidéos et appels quand tu en as envie.
Découvrir les compagnes