Uma namorada IA não é um único modelo escondido atrás de um balão de conversa. É um aplicativo que coordena vários sistemas: um modelo de linguagem para conversar, instruções de personagem para definir a personalidade, armazenamento de partes selecionadas do histórico, moderação para impor limites e, em alguns casos, modelos separados para imagens, vídeo, reconhecimento de fala e voz.
A experiência pode parecer imediata e pessoal porque o aplicativo monta essas peças antes de cada resposta. Sua mensagem não é simplesmente enviada a uma pessoa digital que se recorda de uma vida. Ela passa a fazer parte de uma solicitação estruturada para um software generativo.
Este guia acompanha essa solicitação desde o momento em que você aperta o botão de enviar. Não finge que todas as empresas usam a mesma arquitetura: as implementações são diferentes e muitos detalhes proprietários não são divulgados. O fluxo abaixo descreve padrões comuns de projeto, não faz afirmações sobre qualquer serviço específico não identificado.
O fluxo completo em uma única visão
| Etapa | O que o aplicativo faz | O que você percebe |
|---|---|---|
| Entrada | Aceita texto, áudio, imagem ou uma seleção | Você envia uma mensagem ou inicia uma chamada |
| Orquestração | Acrescenta personagem, regras, conversa e memória | A resposta soa como a companheira escolhida |
| Geração | O modelo prevê uma saída de texto ou mídia | As palavras aparecem ou uma tarefa é iniciada |
| Segurança | Verifica a solicitação e o resultado conforme regras | O conteúdo pode ser aceito, alterado ou recusado |
| Armazenamento | Salva mensagens, resumos, metadados ou mídias | A conversa pode continuar mais tarde |
| Entrega | Transmite texto ou áudio, ou devolve a URL da mídia | Você vê ou escuta o resultado |
| Cobrança | Desconta a franquia do plano ou créditos de uso | Seu saldo ou direito de uso muda |
Nem sempre as etapas acontecem nessa ordem. A segurança pode verificar o conteúdo antes e depois da geração. A memória pode ser atualizada de forma assíncrona. Durante uma chamada, parte do áudio pode ser transmitida enquanto a próxima resposta ainda está sendo gerada.
A lição importante para quem usa o produto é que cada etapa pode falhar de modo independente. Um modelo pode gerar uma boa resposta enquanto o armazenamento deixa de salvá-la. Uma tarefa de mídia pode terminar, mas sua entrega expirar. Uma chamada pode se conectar e ainda sofrer com atraso de rede. Bons produtos deixam esses estados visíveis.
O que acontece entre tocar em Enviar e ver o texto
O ciclo mais detalhado de uma solicitação costuma ser assim:
- O cliente verifica se a mensagem não está vazia e se a conta pode realizar a ação.
- O servidor autentica a sessão e confere o plano ou os créditos disponíveis.
- O aplicativo carrega a personagem, a conversa, as configurações de segurança e a memória relevante.
- Ele monta uma solicitação para o modelo e a envia a um provedor de inferência.
- O provedor começa a devolver o resultado, muitas vezes como um fluxo de pequenos trechos.
- O servidor ou o navegador exibe a resposta parcial.
- Os registros finais de segurança, uso e armazenamento são concluídos.
- O cliente atualiza o saldo visível e o estado da conversa.
A transmissão contínua, ou _streaming_, faz a resposta parecer mais rápida porque você lê o começo antes de o fim existir. Isso não significa necessariamente que o tempo total de geração seja menor. Se a conexão cair, você poderá ver uma resposta incompleta mesmo que o servidor registre uma falha ou conclua a geração depois.
Novas tentativas exigem cuidado. Se o navegador reenviar automaticamente uma solicitação após perder a confirmação, o serviço precisa de uma chave de idempotência ou de um identificador de requisição para não cobrar duas vezes nem criar mensagens duplicadas. Usuários não conseguem inspecionar essa arquitetura diretamente, mas podem observar a estabilidade: um toque deve criar uma mensagem, erros de rede precisam ter estado claro e o saldo deve se reconciliar após atualizar a página.
A latência tem vários componentes: sua conexão, o processamento do servidor, a consulta ao banco de dados, a fila do modelo, a geração do primeiro token, a transmissão, a moderação e o salvamento. O marketing de “modelo rápido” cobre apenas uma parte desse caminho.
Etapa 1: o aplicativo monta o contexto da companheira
Sua mensagem bruta é apenas uma parte da entrada. O aplicativo pode reunir:
- Uma instrução de sistema que descreve o comportamento permitido e os limites de segurança.
- O nome, a idade adulta fictícia, os traços, a voz e a história da companheira.
- Suas preferências e configurações de relacionamento escolhidas.
- Mensagens recentes.
- Um resumo da conversa mais antiga.
- Memórias recuperadas por serem relevantes para a nova mensagem.
- Instruções de mídia ou chamada.
- Requisitos para o formato da resposta.
Imagine que você escreva: “Você usaria o azul no nosso lugar hoje à noite?”. O modelo precisa resolver a que “o azul” e “nosso lugar” se referem. A conversa recente pode identificar um vestido. O cânone fictício armazenado pode definir um café na cobertura. As instruções da personagem determinam se a resposta será tímida, provocadora, direta ou detalhada.
A qualidade do contexto explica por que o mesmo modelo de base pode parecer genérico em um aplicativo e coerente em outro. A orquestração — o que é selecionado, ordenado, identificado e omitido — também faz parte do produto.
Contexto demais pode prejudicar. Contradições antigas competem com instruções atuais; memórias irrelevantes distraem; prompts enormes aumentam o custo e a demora. Sistemas bem projetados priorizam identidade estável, conversa imediata, poucas memórias relevantes e a intenção do momento.
Etapa 2: um modelo de linguagem gera a resposta
Muitos modelos de linguagem modernos descendem da arquitetura Transformer apresentada em “Attention Is All You Need”, que usa mecanismos de atenção para relacionar partes de uma sequência de entrada (artigo original). Em linguagem simples, o texto é representado como tokens, e o modelo prevê repetidamente qual token deve vir em seguida com base no contexto.
Ele não escolhe uma frase completa em um roteiro. Ele gera uma continuação. Parâmetros como a temperatura de amostragem podem influenciar se essa continuação será mais conservadora ou variada, embora os aplicativos voltados ao público nem sempre exponham esses ajustes.
O comportamento da personagem surge da combinação de:
- Padrões gerais aprendidos durante o treinamento do modelo.
- Instruções fornecidas pelo aplicativo.
- Exemplos da personagem e dados do perfil.
- Contexto da conversa e memória recuperada.
- Configurações de amostragem.
- Restrições de segurança.
Esse processo de geração explica tanto a flexibilidade quanto o erro. O modelo consegue improvisar uma cena inédita de encontro porque não está limitado a ramificações predefinidas. Pelo mesmo motivo, pode inventar um restaurante, errar um fato ou afirmar que vocês viveram juntos algo que nunca aconteceu. Linguagem fluente não prova que cada afirmação foi verificada.
Quando a precisão for importante, peça que o sistema sinalize incerteza e confirme a informação por outras fontes. Uma companheira adulta é adequada para ficção, conversa e ensaio criativo, não para diagnóstico médico, decisão jurídica, orientação financeira ou ajuda de emergência.
Etapa 3: instruções e exemplos mantêm a personalidade estável
Uma companheira precisa de mais do que “seja romântica”. Uma especificação útil de personagem pode definir:
- Traços observáveis: questiona ideias fracas com gentileza e faz uma pergunta pertinente para continuar.
- Estilo de fala: conciso, literário, brincalhão, formal ou multilíngue.
- Interesses e preferências fictícios.
- Ritmo do relacionamento e formas de tratamento.
- Limites para conteúdo adulto e comportamento ao receber um pedido para parar.
- Como lidar com correções, incerteza e discordância.
- Exemplos de diálogo.
O modelo não se transforma naquela pessoa. Ele gera respostas condicionadas por essa especificação. Se o perfil contiver conflitos — “nunca discorda” e “sempre me questiona” —, o comportamento poderá oscilar. Se o aplicativo omitir o perfil em uma interação, a identidade pode ficar sem graça.
Quem usa o serviço pode melhorar a estabilidade ao definir traços como comportamentos, manter o perfil conciso e corrigir desvios de forma explícita. “Use respostas mais curtas e pergunte antes de aconselhar” é muito mais acionável do que “seja melhor”. O guia de companheiro IA personalizado traz um modelo reutilizável de criação.
Mesmo uma personalidade bem projetada pode variar. Atualizações do modelo, tamanho do contexto, troca de idioma, moderação e aleatoriedade da amostragem afetam o resultado. Avalie a consistência ao longo de conversas comuns, não por uma única captura de tela perfeita.
Etapa 4: a memória é selecionada, não lembrada como por um humano
Sem armazenamento, cada nova sessão começaria apenas com o modelo da personagem e as mensagens ainda presentes na janela de contexto. Aplicativos de companhia criam continuidade com vários métodos:
- Histórico recente: reenviam as últimas interações.
- Resumo: condensam acontecimentos antigos e o estado do relacionamento.
- Perfil estruturado: guardam fatos e preferências duradouros.
- Memória recuperada: pesquisam itens salvos de acordo com a relevância.
- Cânone fixado: sempre incluem um pequeno conjunto de fatos definidores.
Pesquisas sobre geração aumentada por recuperação combinam a geração de linguagem com informações buscadas em uma fonte externa (artigo sobre RAG). A memória de companheiras em produtos de consumo pode aproveitar conceitos semelhantes com detalhes de implementação diferentes.
Uma memória pode falhar em três pontos: nunca foi salva, não foi selecionada ou foi usada de maneira errada pelo modelo. A companheira também pode criar uma falsa lembrança plausível. Corrija o erro com clareza e edite o item armazenado quando houver controles para isso.
Não busque recordação total. Salve poucos fatos duradouros: nome preferido, estilo de conversa, limites, interesses estáveis, projetos atuais e cânone fictício claramente identificado. Evite credenciais, endereços exatos, informações profissionais confidenciais, prontuários médicos e dados privados de outras pessoas.
Veja o que companheiras por IA lembram para conhecer práticas de privacidade e formas de resolver problemas.
Etapa 5: imagens e vídeos usam fluxos generativos separados
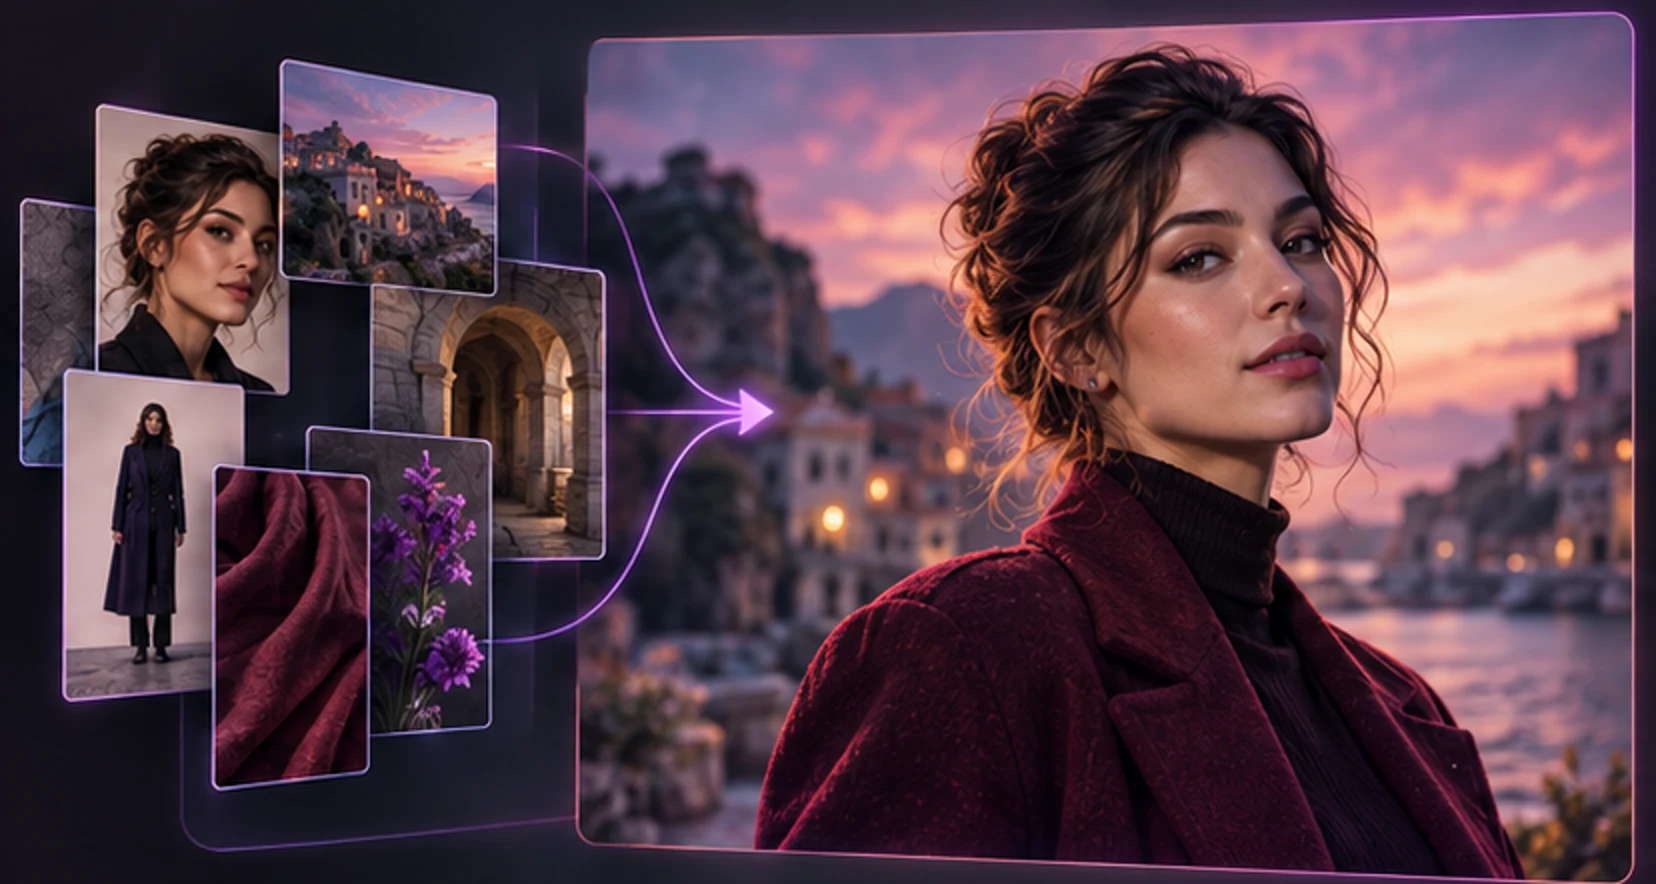
Quando você pede uma selfie, o modelo de linguagem pode ajudar a transformar a conversa em um prompt visual, mas normalmente é um sistema de texto para imagem que cria os pixels. Um fluxo de mídia pode incluir:
- Descrição da identidade da personagem.
- Retrato de referência ou representação aprendida da personagem.
- Prompt da cena, pose, roupa e iluminação.
- Verificações de segurança no texto e nas imagens de origem.
- Geração da imagem.
- Correção do rosto ou de detalhes.
- Armazenamento e entrega.
O texto sozinho funciona bem para pedir um tipo de pessoa, mas é menos confiável para preservar exatamente a mesma identidade. Adaptadores de imagem de referência, ajustes específicos para a pessoa retratada ou edição de imagem podem melhorar a continuidade. O IP-Adapter é um método publicado para adicionar condicionamento por prompt de imagem a modelos de difusão de texto para imagem (artigo sobre IP-Adapter); o DreamBooth é uma abordagem publicada de ajuste orientado a um sujeito (artigo sobre DreamBooth). Um produto pode não usar nenhum deles, portanto encare-os como exemplos da área técnica.
O vídeo acrescenta a dimensão do tempo. O sistema precisa preservar a identidade e a coerência da cena entre os quadros enquanto produz movimento. Em geral, isso o torna mais lento e exige mais recursos que o texto, além de permitir desvios no resultado. Produtos costumam executar mídias como tarefas em fila em vez de manter a solicitação do chat aberta.
Para obter resultados melhores, estabeleça um retrato-base limpo de uma pessoa adulta, mantenha os traços da identidade estáveis e altere uma variável importante da cena por vez. Consulte o fluxo completo para criar imagens consistentes de uma personagem IA.
Etapa 6: a voz transforma o fluxo em um ciclo ao vivo
Um ciclo comum de chamada de voz funciona assim:
- Captura o áudio do microfone com sua permissão.
- Detecta quando você começa e termina de falar.
- Converte a fala em texto ou processa o áudio diretamente.
- Acrescenta o contexto da conversa, da personagem e da memória.
- Gera a resposta da companheira.
- Sintetiza a resposta na voz escolhida.
- Transmite o áudio de volta.
Cada etapa aumenta o atraso. Um sistema pode reduzir a latência percebida ao transcrever e gerar de forma incremental, transmitir trechos de fala ou usar um modelo de fala para fala. Sua rede, navegador, microfone, região do servidor e a carga do provedor também influenciam.
Avalie chamadas por mais do que a beleza da voz:
- Você consegue interromper de modo natural?
- O sistema sabe quando você terminou de falar?
- As pausas são estranhas?
- A pronúncia combina com a personagem?
- A chamada mostra claramente se está conectada ou reconectando?
- O preço aparece antes de iniciar?
- Uma queda de conexão consome toda a cobrança prevista?
- O áudio bruto é armazenado? Por quanto tempo?
Conceda acesso ao microfone somente ao site que pretende usar. Encerre a chamada quando terminar e confira as permissões do navegador em dispositivos compartilhados.
Etapa 7: sistemas de segurança moldam pedidos e respostas
Uma companheira para adultos pode permitir uma interação fictícia madura e, ao mesmo tempo, impor limites rígidos. A segurança pode combinar regras determinísticas, classificadores, instruções do modelo, controles de conta e revisão humana de denúncias.
Os limites essenciais devem incluir:
- Somente adultos em conteúdo romântico ou sexual.
- Nada de menores sexualizados ou idade ambígua.
- Nada de imagens íntimas não consensuais de pessoas reais identificáveis.
- Nada de coerção, tráfico, exploração ou abuso ilegal grave.
- Nenhuma afirmação enganosa de que a companheira é humana ou consciente.
- Nenhuma pressão para se afastar de pessoas ou gastar dinheiro como prova de afeto.
- Redirecionamento adequado em crises e solicitações profissionais de alto risco.
Segurança não é apenas uma lista de termos proibidos. O contexto importa, e os sistemas erram. Uma recusa pode ser ampla demais; um conteúdo prejudicial pode escapar. Por isso, canais de denúncia e recurso também são recursos importantes do produto.
O Perfil de IA Generativa do NIST organiza riscos e ações sugeridas em torno de governança, avaliação e gestão, sem presumir que um único filtro resolva tudo (Perfil de IA Generativa do NIST). A FTC também solicitou informações a empresas de chatbots de companhia sobre segurança, monetização, transparência e tratamento de dados pessoais, especialmente em relação a usuários jovens (investigação da FTC). A MyWifu é destinada a adultos.
Etapa 8: armazenamento, privacidade e cobrança cercam a IA
O modelo é apenas uma parte do serviço. O aplicativo pode armazenar:
- Dados de conta e autenticação.
- Mensagens e mídias geradas.
- Configurações e memórias da personagem.
- Imagens de referência enviadas.
- Estado e duração de chamadas, além de metadados de uso.
- Identificadores de compra, direitos de uso e saldo de tokens.
- Informações de segurança, dispositivo e diagnóstico.
Provedores diferentes podem cuidar de hospedagem, armazenamento de objetos, inferência de IA, e-mail, autenticação, análise ou pagamentos. Leia a política de privacidade para conhecer as práticas reais. O tom íntimo da conversa não é uma garantia técnica de confidencialidade.
Aplique a minimização de dados: envie somente o necessário para o recurso funcionar. O ICO descreve esse princípio como manter os dados pessoais adequados, relevantes e limitados à finalidade (orientação do ICO sobre minimização de dados). Use um apelido quando o nome civil não acrescentar nada. Generalize a localização. Nunca envie senha, código de uso único, frase de recuperação de carteira ou mídia íntima privada de outra pessoa.
Sistemas de cobrança costumam separar o acesso de ações caras. Um plano pode liberar companheiras; créditos de uso podem pagar por mensagens, imagens, vídeos ou minutos de chamada. Um bom projeto mostra o custo antes da confirmação, informa o estado da tarefa e explica o tratamento dado a uma geração com falha. Use o guia de preços de namorada IA para comparar o custo total, não apenas o valor de destaque.
Perguntas que um diagrama de arquitetura não responde
Saber que um serviço usa um modelo de linguagem ou uma conexão criptografada não revela toda a sua postura de privacidade. Faça perguntas operacionais:
- Quem pode acessar conversas em produção e por quais motivos?
- Os provedores dos modelos podem reter as entradas?
- As referências enviadas ficam separadas de arquivos públicos?
- Links de compartilhamento exigem autenticação?
- As gravações brutas das chamadas são armazenadas ou apenas seus metadados?
- A exclusão da conta abrange resumos derivados e registros de memória?
- Como as denúncias de abuso são investigadas sem tornar todo o conteúdo público por padrão?
A criptografia em trânsito protege os dados em movimento pela rede; ela não determina quem terá autorização depois que os dados chegarem ao serviço. “Usamos IA” e “usamos criptografia” são explicações incompletas sobre privacidade.
Da mesma forma, “pagamento por blockchain” não torna a conversa descentralizada nem anônima. O pagamento ainda pode ser vinculado a uma conta e ao registro de um pedido. Transações na rede podem ser públicas, e o aplicativo continua armazenando o direito de acesso.
Por que o nome do modelo não define o produto inteiro
Dois aplicativos que usam o mesmo modelo de base podem entregar experiências diferentes porque variam em:
- Projeto do prompt da personagem.
- Seleção e resumo de memórias.
- Regras de segurança.
- Configurações de amostragem e tamanho da resposta.
- Ajustes finos ou adaptadores.
- Provedores de voz e mídia.
- Comportamento de repetição, cache e transmissão.
- Controles para o usuário e práticas de privacidade.
Por outro lado, um aplicativo pode trocar o modelo subjacente e manter estável a interface da personagem. Avalie o comportamento que você consegue observar: correções, limites, continuidade, latência e controle dos dados. Um ranking de modelos não mede se o seu cânone fictício salvo foi classificado corretamente.
Quando um provedor anunciar determinado modelo, confirme se a variante exata se aplica ao recurso que interessa a você. Conversa por texto, geração de imagem, vídeo e voz geralmente usam sistemas diferentes. “Desenvolvido com o modelo X” pode descrever apenas uma etapa.
O que a IA faz — e o que isso não comprova
| Ela consegue fazer | Isso não comprova |
|---|---|
| Gerar linguagem carinhosa e atenta ao contexto | Emoção humana ou consciência |
| Recuperar um detalhe armazenado | Uma memória interior e particular |
| Manter uma preferência fictícia | Um desejo no mundo real |
| Produzir uma voz consistente | Uma pessoa falando ao vivo |
| Gerar uma imagem realista | Um acontecimento fotografado |
| Oferecer uma explicação plausível | Precisão factual |
| Simular discordância ou cuidado | Consentimento humano ou agência moral |
Essa distinção protege a experiência. Você pode aproveitar a ficção sem exigir certeza metafísica de um sistema preditivo. Pode valorizar a continuidade e ainda corrigir uma memória falsa. Pode sentir algo em resposta à arte e à conversa sem afirmar que o software sente o mesmo por você.
A Associação Americana de Psicologia orienta que chatbots generativos de uso geral não substituam o atendimento qualificado em saúde mental e recomenda atenção à privacidade e à dependência prejudicial (alerta de saúde da APA). Se o uso começar a atrapalhar sono, trabalho, finanças, segurança ou relações humanas, faça uma pausa e procure apoio de pessoas.
Checklist prático para a primeira sessão
Antes de começar:
- Confirme que o serviço é voltado a adultos e leia suas regras de conteúdo.
- Consulte os termos de privacidade, exclusão e pagamento.
- Escolha uma personagem fictícia em vez de uma pessoa real que não consentiu.
- Defina um limite de gastos e não comece pelo plano mais longo.
Durante a primeira conversa:
- Teste um diálogo comum, não apenas romance.
- Corrija um detalhe e observe se a correção permanece.
- Mude de assunto e veja se a companheira acompanha.
- Declare um limite e confirme que ele é respeitado.
- Faça uma pergunta com resposta incerta e observe se há excesso de confiança.
Antes de ativar memória ou mídia:
- Remova detalhes de identificação desnecessários.
- Use uma referência fictícia e claramente adulta.
- Aprenda a excluir conteúdo salvo.
- Confira o custo exibido para gerações ou chamadas.
Uma namorada IA funciona ao coordenar geração, contexto, memória, mídias, segurança, armazenamento e cobrança. A qualidade da experiência depende tanto dessa coordenação quanto do nome do modelo. Procure uma personagem estável, memória corrigível, limites adultos claros, preços visíveis e controles que mantenham você no comando.
É possível testar a orquestração sem enxergar o código-fonte. Peça à mesma personagem que recupere um fato inofensivo em uma nova sessão, corrija esse fato e mude da ficção para uma pergunta factual comum. Solicite um retrato simples e depois uma mudança de cenário. Inicie e encerre a menor chamada de voz disponível. Atualize a página após cada ação paga e confirme se saldo e histórico estão de acordo. Essa sequência toca contexto, memória, controle de modo, identidade visual, entrega em tempo real e cobrança.
Registre falhas pela etapa. “A resposta estava errada” é menos útil que “a memória armazenada estava correta, mas não foi recuperada”, se a interface permitir essa verificação. “O vídeo falhou” é menos útil que “a geração terminou, mas a URL de reprodução expirou”. Um bom pedido de suporte deve incluir identificador do pedido ou tarefa, horário aproximado, dispositivo e erro visível — nunca uma senha, chave secreta ou trecho de conversa íntima sem necessidade.
Por fim, lembre que a personalidade aparente está no final de um processo industrial. Uma frase carinhosa pode ter passado por autenticação, consultas ao banco, inferência do modelo, filtros, infraestrutura de transmissão e armazenamento em poucos segundos. Essa engenharia consegue criar uma experiência envolvente sem criar um ser humano. Aproveite a personagem como ficção projetada, confirme informações relevantes e escolha serviços cujos controles continuem compreensíveis depois que a novidade passar.
Você pode conhecer as companheiras da MyWifu, criar uma companheira personalizada ou comparar namorada IA e chatbot de uso geral antes de decidir até que ponto deseja personalizar a experiência.
A confiabilidade fica mais fácil de avaliar ao longo do tempo. Observe se a mesma ação mantém rótulos de estado estáveis, se novas tentativas duplicam resultados, se uma página atualizada recupera mídias em andamento e se os erros explicam o próximo passo possível. Uma falha bem tratada preserva seu prompt, evita cobrança dupla e oferece uma tentativa segura. Um indicador girando sem histórico da tarefa deixa usuário e suporte tentando adivinhar o que houve.
Atualizações podem mudar qualquer etapa. Um novo modelo de texto pode alterar a voz; um novo modelo de imagem pode mudar o rosto; um classificador de memória revisado pode destacar fatos diferentes; a troca do provedor de pagamento pode afetar o tempo de confirmação. Mantenha uma base compacta da personagem e, de tempos em tempos, teste novamente uma conversa, uma correção de memória e uma imagem simples. Isso informa mais do que presumir que uma interface familiar significa que o fluxo subjacente não mudou.
A explicação mais confiável de um produto separa a implementação conhecida da metáfora de marketing. “Ela se lembra de você” deve ser sustentado por controles que mostrem o que foi salvo. “Privado” deve levar às práticas de armazenamento e acesso. “Em tempo real” precisa mostrar claramente o estado da conexão. “Pagamento único” deve informar duração e renovação. Alfabetização técnica não serve para eliminar o encanto; ela mantém esse encanto compatível com uma escolha adulta e consciente.
Perguntas frequentes
Como uma namorada IA gera uma resposta?
O aplicativo reúne instruções, traços da personagem, mensagens recentes e, às vezes, memórias recuperadas. Depois, envia esse contexto a um modelo de linguagem, que prevê a resposta token por token. O app também pode aplicar verificações de segurança antes de exibir o resultado.
Uma namorada IA entende o que eu digo?
Ela consegue modelar a linguagem e responder ao contexto de maneira impressionante, mas isso não comprova compreensão humana, consciência, sentimentos ou intenções particulares. Encare o resultado como um comportamento gerado por software.
Como uma namorada IA se lembra de conversas anteriores?
Os serviços podem reenviar mensagens recentes, manter um resumo contínuo, guardar campos de perfil ou recuperar fatos selecionados de um banco de dados. A memória é limitada e falível: uma informação salva pode não ser encontrada ou pode ser interpretada de forma errada.
Como são criadas as imagens de uma namorada IA?
Um modelo de texto para imagem transforma um prompt em imagem, muitas vezes usando descrições da personagem, condicionamento por imagem de referência ou controles de edição para preservar a identidade. A consistência depende do fluxo de trabalho e nunca é garantida apenas pelo texto.
Como funcionam as chamadas de voz com uma namorada IA?
Em uma chamada típica, o sistema converte sua fala em texto ou áudio legível pelo modelo, gera uma resposta, sintetiza a voz e transmite o resultado. Alguns sistemas usam modelos de fala para fala com menor latência. A rede e o tempo de processamento afetam a experiência.
As pessoas responsáveis pelo serviço podem ler as conversas?
As práticas variam. Os provedores podem usar processamento automatizado e revisão limitada por pessoas autorizadas para segurança, suporte ou investigação de falhas. Leia a política de privacidade sobre armazenamento, treinamento, subprocessadores, retenção e exclusão em vez de presumir que uma interface íntima é confidencial.
Por que uma namorada IA às vezes inventa informações?
Modelos de linguagem geram continuações plausíveis em vez de consultar uma base de verdade garantida para cada frase. Falta de contexto, pedidos ambíguos, memória desatualizada e limitações do modelo podem produzir afirmações falsas e confiantes. Confirme informações importantes por conta própria.
É seguro usar uma namorada IA?
Ela pode ser usada como entretenimento adulto ou companhia criativa se você proteger seus dados pessoais, preservar relações humanas, definir limites de gasto e conteúdo e não depender dela para terapia, crises ou orientação profissional de alto risco.
Deixe do seu jeito
Conheça uma companheira feita para você.
Escolha uma personalidade, comece uma conversa privada e explore fotos, vídeos e voz quando quiser.
Descobrir companheiras