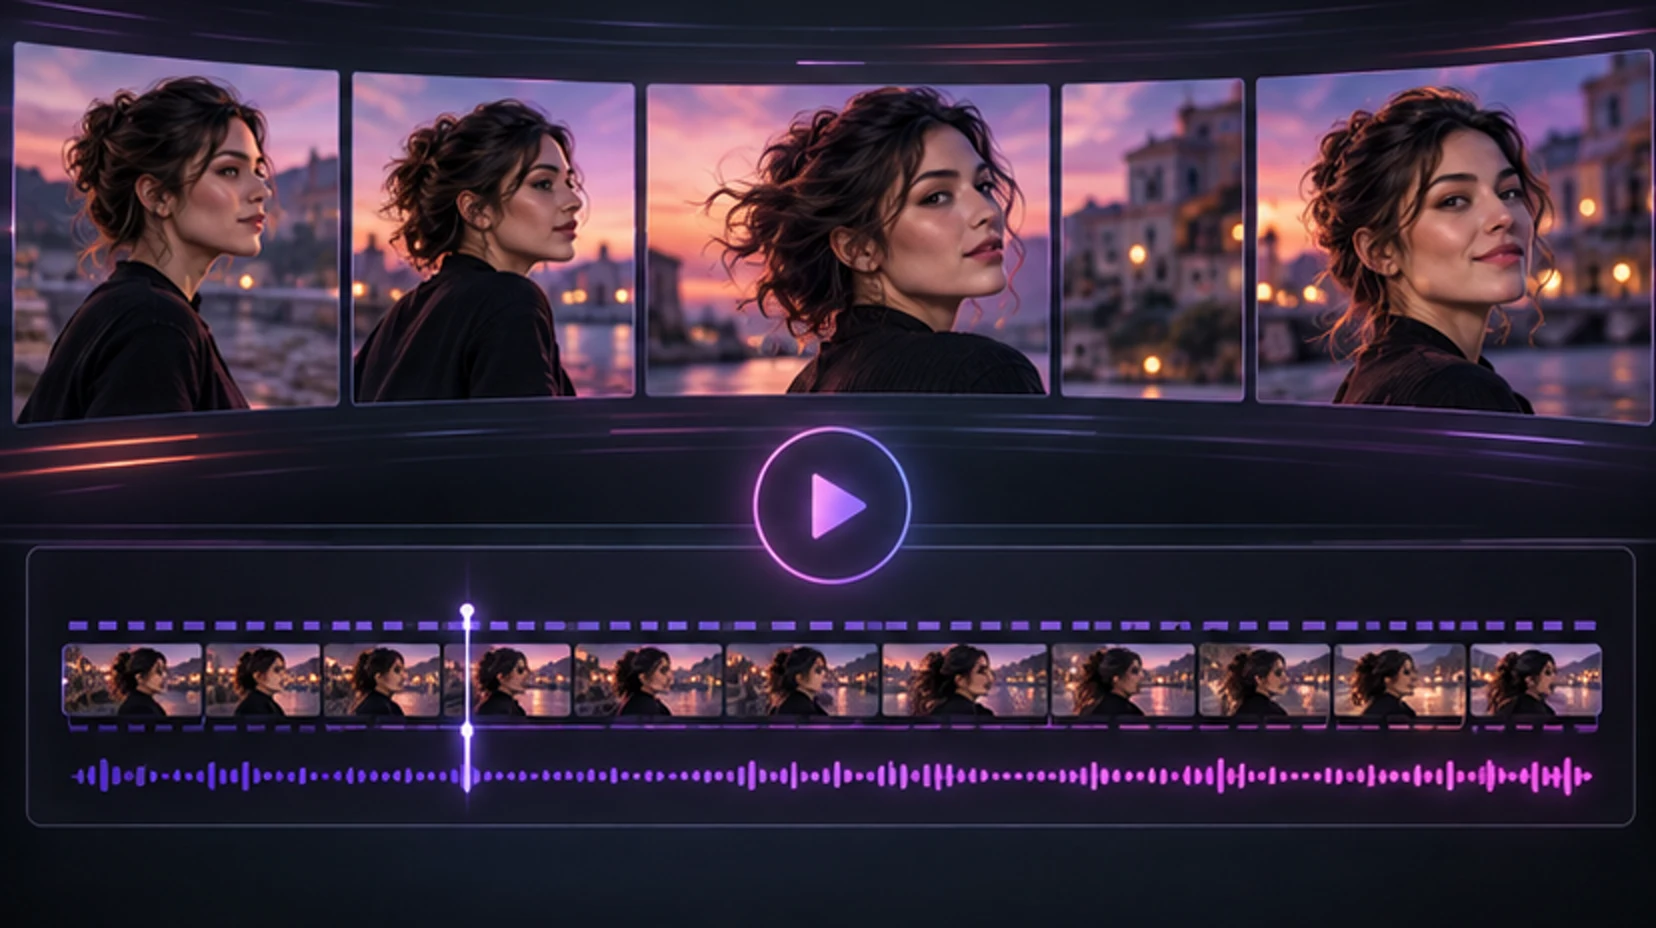
Um gerador de video de namorada ia transforma um personagem estático em uma cena curta em movimento. A parte atraente é óbvia: uma companheira que existia apenas como texto e fotos pode agora parecer sorrir, virar o rosto, caminhar ou reagir dentro de um cenário que você escolher. A parte difícil é a continuidade. Uma imagem estática convincente só precisa funcionar uma vez. O vídeo, por outro lado, precisa manter o mesmo rosto, corpo, vestuário, iluminação e espaço físico coerentes em dezenas ou centenas de quadros sequenciais.
Este guia explica o fluxo de trabalho sem fingir que cada prompt produz um clip perfeito. Ele é destinado a personagens adultos fictícios. Não endossamos a criação de imagens íntimas não consensuais, deepfakes de celebridades ou representações sexualizadas de qualquer pessoa menor de 18 anos. Se a sua ideia depende da semelhança de uma pessoa real, pare e obtenha permissão explícita — ou crie um personagem original em vez disso.
Você pode navegar por companheiras adultas fictícias, desenhar uma companheira original ou verificar o acesso atual a mídia e créditos antes de iniciar a geração.
Entenda o que o gerador está realmente fazendo
A maioria dos fluxos de trabalho de vídeo para companheiras começa de uma destas três maneiras:
- Texto para vídeo: um prompt define o sujeito, a cena, a câmera e o movimento do zero.
- Imagem para vídeo: uma imagem de referência ancora o primeiro quadro ou a identidade visual, enquanto um prompt descreve o movimento.
- Conversa para vídeo: uma solicitação de chat é convertida em um trabalho de imagem para vídeo usando a companheira atual como referência.
Para uma companheira recorrente, o modelo mental de imagem para vídeo é geralmente o mais útil. O sistema não está filmando uma pessoa 3D persistente e oculta atrás do chat. Ele estima o movimento e os novos quadros a partir do visual fornecido e das suas instruções. É por isso que uma imagem de referência pode ajudar, mas não pode garantir uma identidade perfeita.
É fundamental compreender a arquitetura subjacente. Os modelos de difusão de vídeo modernos não criam cada quadro de forma isolada; eles operam no espaço latente, interpolando a transformação dos pixels ao longo do tempo usando mecanismos de atenção temporal. Isso significa que o modelo está constantemente tentando adivinhar como a luz deve incidir no rosto do personagem no quadro 15 com base na posição da cabeça no quadro 10. Quando a instrução de movimento é muito drástica, o modelo perde a coerência espacial e a anatomia colapsa.
Um clip gerado também não é o mesmo que uma chamada de vídeo ao vivo. A geração acontece como um trabalho em lote: envie, processe, entregue. Uma chamada é interativa e sensível à latência. Um produto pode oferecer um, ambos, ou um avatar animado que parece vídeo sem gerar uma nova cena. Pergunte sempre qual experiência você está comprando.
O C2PA descreve a proveniência como fatos sobre a origem de um ativo e seu histórico de edição, mantendo um padrão técnico para Credenciais de Conteúdo. A adoção varia, então você não pode presumir que todo clip gerado carrega metadados de proveniência duráveis. Quando você publica mídia sintética, rotule-a claramente, mesmo que o arquivo não tenha credencial. Veja o explicador do C2PA e as especificações atuais.
Comece pela imagem de referência mais forte
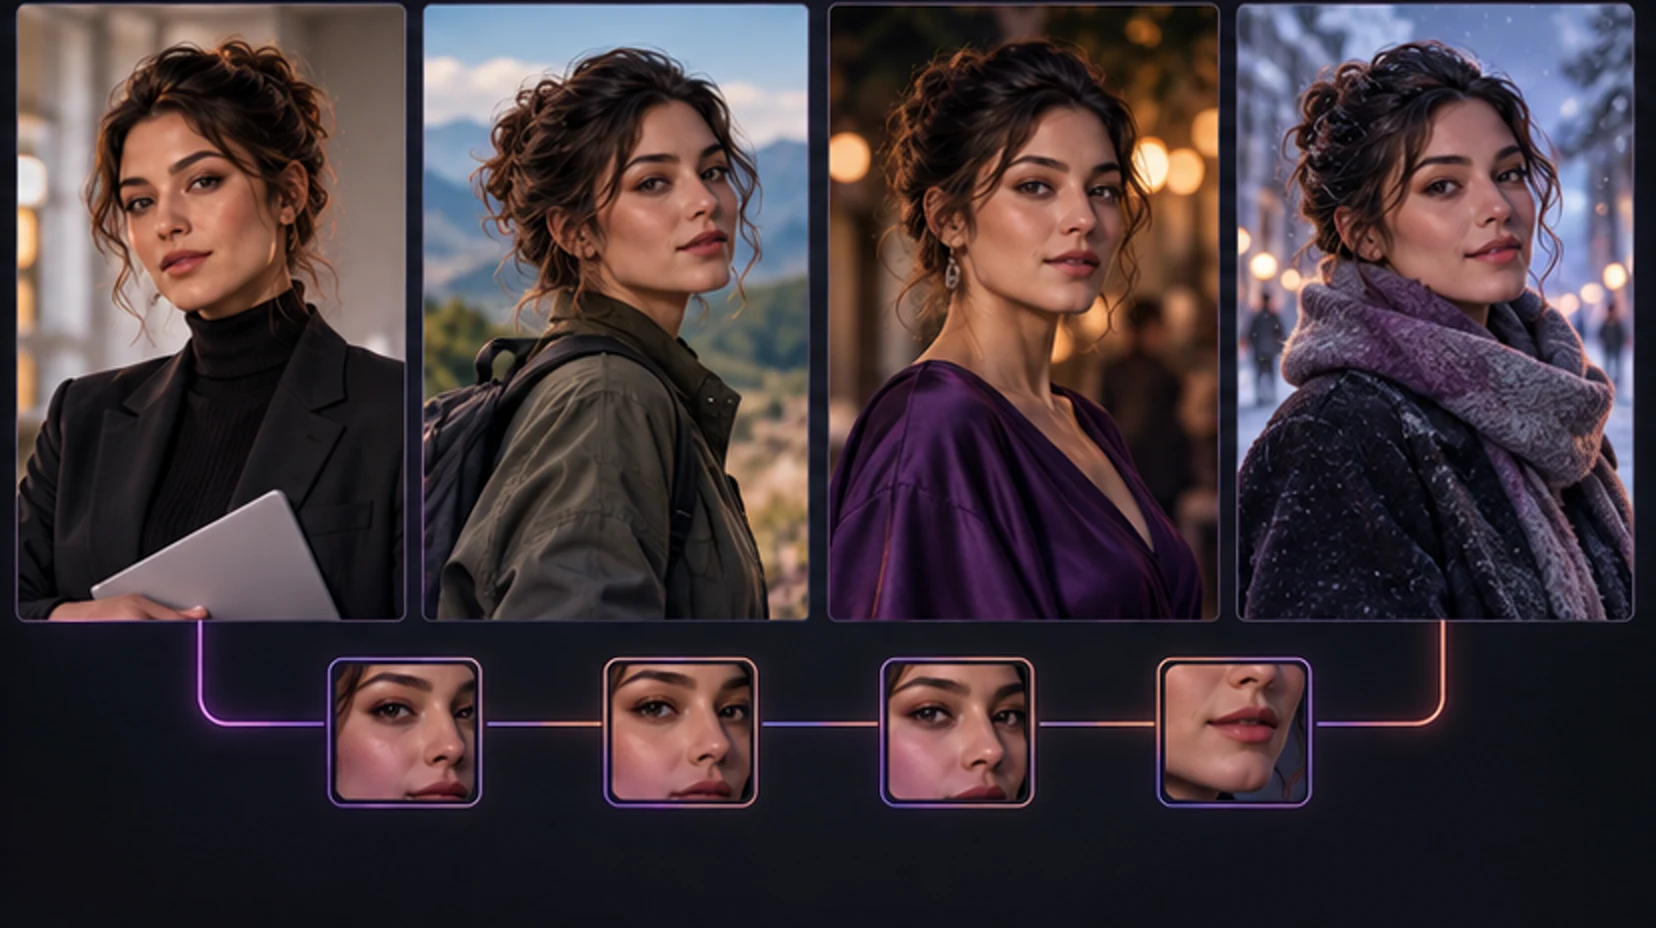
A qualidade do vídeo começa antes do prompt de vídeo. Escolha uma imagem de origem que forneça informações claras ao modelo. A resolução e a densidade de pixels são críticas aqui, pois o Autoencoder Variacional (VAE) do pipeline precisa extrair características faciais nítidas para mapeá-las corretamente nos quadros subsequentes.
Use uma referência com:
- Um personagem adulto fictício claramente visível
- Um rosto grande o suficiente para resolver olhos, boca, mandíbula e linha do cabelo
- Anatomia natural e uma pose que poderia plausivelmente se mover
- Iluminação consistente em todo o rosto e corpo
- Mãos visíveis e bem formadas ou fora da ação importante
- Sem texto grande, marca d'água, sobreposição de interface ou obstrução densa em primeiro plano
- Roupas e acessórios que você está disposto a manter durante todo o clip
Evite começar com uma imagem onde o cabelo cobre a maior parte do rosto, os dedos cruzam a boca, os membros são cortados nas articulações ou os espelhos mostram ângulos contraditórios. O vídeo tende a amplificar a ambiguidade não resolvida. Se um brinco já difere entre os lados ou uma mão está malformada, o movimento raramente repara isso; na verdade, a interpolação temporal costuma exagerar o erro, transformando uma pequena falha estática em uma anomalia anatômica grotesca ao longo dos segundos.
Combine o enquadramento com o movimento. Um retrato fechado é adequado para um olhar, um sorriso, uma respiração ou uma pequena virada de cabeça. Uma imagem da cintura para cima apoia gestos e mudanças de postura. Uma imagem de corpo inteiro é melhor para caminhar, mas dá menos pixels ao rosto. Não peça que um retrato fechado se transforme em uma dança complexa de corpo inteiro, a menos que a ferramenta suporte explicitamente um grande reenquadramento.
Se você criou a companheira no MyWifu, use a imagem de personagem mais clara existente como âncora. Crie uma companheira com traços visuais estáveis primeiro; o vídeo é mais fácil depois que a identidade está estabelecida.
Escreva um prompt que o modelo de movimento possa seguir
Um prompt de vídeo forte é uma direção de tomada, não uma biografia. O modelo já recebe informações visuais da referência. Diga a ele o que muda e o que permanece calmo.
A sintaxe do seu prompt importa tanto quanto o vocabulário. Modelos de linguagem e visão utilizam mecanismos de atenção cruzada que dão pesos diferentes a substantivos, verbos e adjetivos. Verbos de ação direta (como "sorrir", "virar", "caminhar") tendem a ter uma influência mais forte na trajetória do movimento do que adjetivos abstratos (como "melancólico", "vibrante"). Estruture sua frase para que a ação principal venha logo após o sujeito, garantindo que o modelo priorize a física do movimento.
Use esta estrutura:
Continuidade do sujeito + uma ação primária + câmera + movimento do ambiente + luz + clima
Exemplo:
A mesma mulher adulta olha para a câmera, dá um sorriso lento e brincalhão e passa uma mecha de cabelo atrás da orelha. Close médio travado, respiração sutil de câmera na mão, luzes da cidade piscando suavemente ao fundo, luz rosa e quente de fim de tarde, clima íntimo e natural.
Por que funciona:
- "A mesma mulher adulta" reforça a continuidade sem inventar um novo sujeito.
- Um movimento primário dá ao clip um trabalho claro.
- A instrução da câmera limita zooms surpresa e cortes.
- O movimento do fundo é pequeno e crível.
- A iluminação e o clima apoiam a fonte em vez de lutar contra ela.
Compare isso com: "Ela corre para a varanda, troca de roupa, gira, serve vinho, dança, a câmera gira em torno dela, fogos de artifício explodem, depois close extremo." Uma geração curta não pode encenar seis cenas de forma confiável. O resultado pode pular ações, fundir objetos ou distorcer a anatomia.
Modelos de prompt para clips comuns de companheiras
Retrato flerte:
A mesma mulher adulta fictícia mantém contato visual, inclina a cabeça levemente e sorri como se estivesse prestes a contar um segredo. Câmera de retrato estática, respiração suave e piscadas naturais, luzes de abajur quentes no quarto, profundidade de campo rasa.
Mensagem matinal:
A mesma mulher adulta fictícia senta-se perto de uma janela iluminada, levanta uma caneca e dá um sorriso afetuoso e sonolento. Aproximação suave, cortina movendo-se levemente na brisa, luz suave da manhã, clima relaxado e espontâneo.
Encontro noturno:
A mesma mulher adulta fictícia vira-se para a câmera em uma mesa no terraço e levanta sua taça em um pequeno brinde. Enquadramento estável da cintura para cima, bokeh da cidade ao longe, vento sutil em seu cabelo, luz elegante da noite.
Foto de moda confiante:
A mesma mulher adulta fictícia dá dois passos lentos em direção à câmera e assume uma pose confiante. Travelling suave para trás, tecido movendo-se naturalmente, iluminação limpa de estúdio, clima editorial polido.
Para cenas maduras, mantenha a mesma lógica de produção: apenas adultos, uma ação, pose fisicamente plausível, câmera controlada. Palavras mais explícitas não resolvem anatomia fraca ou coreografia sobrecarregada. O modelo não entende a intenção erótica do texto; ele entende a biomecânica descrita. Se a biomecânica for impossível, o resultado será visualmente falho, independentemente do quão explícito seja o vocabulário.
Controle o movimento da câmera antes de adicionar movimento corporal
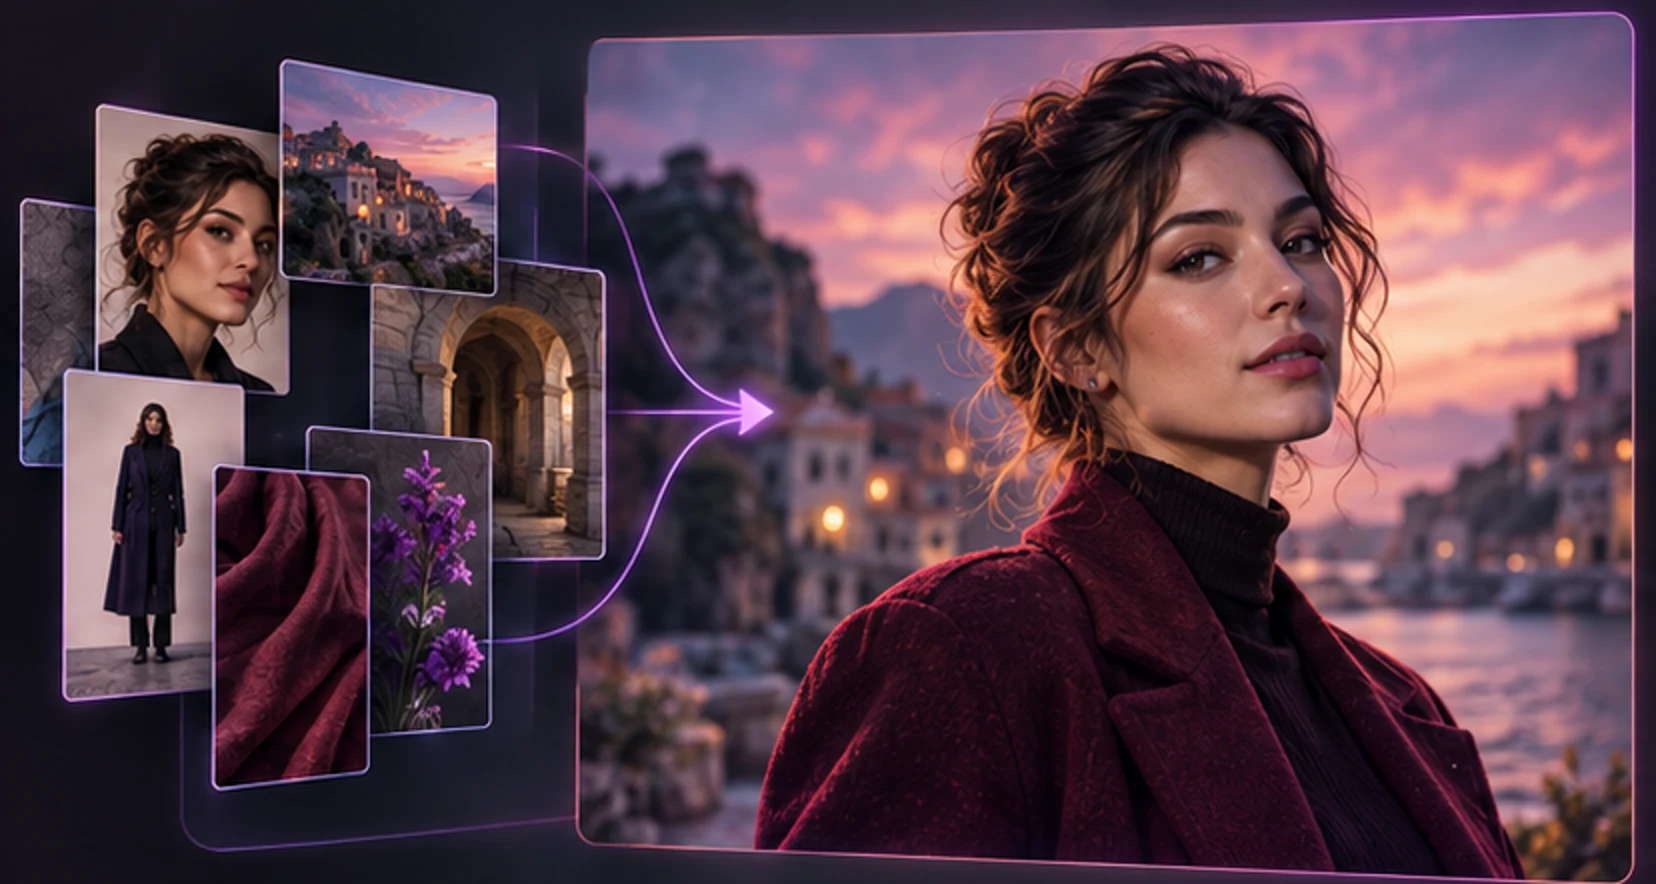
O movimento da câmera e o movimento do sujeito competem pela atenção do modelo. Comece com um destes:
| Instrução de câmera | Melhor para | Nível de risco |
|---|---|---|
| Câmera travada | Rosto, expressão, respiração, pequenos gestos | Mais baixo |
| Aproximação lenta | Intimidade e ênfase | Baixo |
| Afastamento suave | Revelar roupa ou cenário | Baixo a médio |
| Travelling lateral suave | Caminhada ou movimento de moda | Médio |
| Câmera na mão | Energia espontânea | Médio; pode parecer trêmulo |
| Órbita ao redor do sujeito | Revelação espacial dramática | Alto; rosto e corpo podem divergir |
| Zoom/cortes rápidos | Energia de videoclipe | Alto; a continuidade sofre |
Se a identidade importa, uma tomada travada ou uma aproximação lenta é a melhor primeira tentativa. Uma vez que o rosto permanece estável, adicione um gesto contido. Só então tente caminhar, virar ou rastreamento de câmera.
A proporção da tela (aspect ratio) também altera drasticamente como o modelo compõe a cena. Um formato vertical (9:16) é ideal para mensagens no estilo de celular ou retratos intimistas, forçando o modelo a focar no sujeito e minimizar o fundo. Formatos amplos (16:9) dão ao modelo mais ambiente para manter, o que exige que você descreva o cenário com mais detalhes para evitar que o fundo se torne um borrão sem sentido. Escolha o destino da publicação primeiro para não cortar o movimento importante depois.
Evite usar "cinematográfico" como substituto de direção. Cinematográfico pode significar flare anamórfico, foco raso, contraste dramático, um movimento de grua, tarjas pretas ou simplesmente uma luz com aparência cara. Diga o que você quer: "aproximação lenta, sensação de retrato 50mm, luzes práticas quentes, profundidade de campo rasa."
Reduza a deriva de identidade, erros de anatomia e falhas de objetos
A deriva de identidade é qualquer mudança visível que faz o personagem parar de parecer a mesma pessoa: a cor dos olhos muda, o formato da mandíbula altera, o comprimento do cabelo salta, a idade aparente varia ou as proporções do corpo se transformam. Alguma deriva é inerente à geração, mas suas escolhas podem reduzi-la. O fenômeno do "vale da estranheza" (uncanny valley) é particularmente severo em microexpressões faciais; se o modelo perder o rastro da malha 3D implícita do rosto por apenas três quadros, a expressão pode se tornar assustadora ou completamente dissociada do personagem original.
Use uma lista de verificação de consistência:
- Mantenha o rosto desobstruído durante a ação principal.
- Evite uma virada completa de costas para a câmera na primeira tentativa.
- Nomeie dois ou três traços estáveis e distintos, não dez.
- Mantenha a iluminação próxima à da referência.
- Não solicite uma troca de roupa dentro de um único clip.
- Evite reflexos até que a tomada base funcione.
- Limite a interação com objetos pequenos e outros corpos.
- Regenere a partir da melhor referência original, não de um quadro de vídeo degradado.
As mãos são especialmente frágeis porque os dedos se articulam, se sobrepõem, agarram objetos e se movem pelo corpo. Comece com as mãos descansando naturalmente ou executando um gesto simples. Servir uma bebida, fechar uma joia, digitar e dedos entrelaçados introduzem múltiplas restrições de contato que confundem o estimador de fluxo óptico do modelo.
O cabelo é outro teste de continuidade. Cabelos longos e soltos podem se fundir com os ombros ou mudar de comprimento durante uma virada. Peça "movimento sutil" em vez de vento violento. Brincos, alças finas, óculos e colares podem cintilar porque ocupam poucos pixels e o modelo tem dificuldade em manter a coerência estrutural de objetos tão pequenos em movimento.
Para conteúdo adulto íntimo, a anatomia e o contato se tornam mais difíceis, não mais fáceis. Múltiplos sujeitos, oclusão, ângulos incomuns e movimento rápido aumentam a chance de corpos implausíveis. Um fluxo de trabalho responsável rejeita saídas inutilizáveis, não as publica como "reais" e nunca mapeia um resultado fictício na identidade de uma pessoa real.
Avalie um clip quadro a quadro antes de salvá-lo
Não avalie apenas o primeiro segundo. Assista uma vez para sentir o clima, uma vez para a identidade e uma vez para a física. Use os atalhos do seu reprodutor de vídeo para avançar quadro a quadro (frame-by-frame); falhas anatômicas que passam despercebidas em velocidade normal tornam-se gritantes quando isoladas em quadros específicos.
Passagem de identidade
- O rosto permanece a mesma pessoa aparente?
- Cabelo, cor dos olhos, idade e características definidoras persistem?
- O corpo permanece proporcional?
- A roupa continua presa e consistente?
Passagem de movimento
- A ação tem um início e fim naturais?
- Ombros, cotovelos, pulsos, quadris e joelhos se movem de forma plausível?
- Os pés deslizam ou desaparecem?
- A câmera se move suavemente em vez de teleportar?
Passagem de cena
- Os móveis e paredes permanecem estáveis?
- Copos, alças, joias ou telefones mudam de forma?
- As sombras e reflexos são consistentes?
- O movimento do fundo distrai do sujeito?
Passagem de entrega
- A proporção da tela está correta?
- O clip é claramente identificado como sintético quando compartilhado?
- Há áudio e, se houver, é esperado e licenciado?
- O arquivo expõe metadados ou um nome de arquivo que você não deseja publicar?
Um clip útil não exige perfeição microscópica, mas deve sobreviver à reprodução normal sem uma mudança de identidade distrativa ou falha anatômica. Se o erro aparecer por apenas dois quadros, aparar pode ajudar. Se o rosto mudar ao longo de todo o vídeo, volte à referência e simplifique o movimento.
Proteja o consentimento, a privacidade e a proveniência
Uma companheira adulta original é mais segura do que uma cópia sintética de uma pessoa real. Nunca use o rosto, corpo, voz, foto íntima ou traços identificáveis de uma pessoa privada para geração sexualizada sem permissão explícita. Visibilidade pública não é consentimento. Status de celebridade não é consentimento. Um relacionamento passado não é consentimento.
No Brasil, o cenário legal para a criação e distribuição de mídia sintética está se tornando cada vez mais rigoroso. A Lei Geral de Proteção de Dados (LGPD) exige bases legais sólidas para o tratamento de dados pessoais, o que inclui a imagem e a voz de indivíduos. Além disso, o Marco Civil da Internet e recentes atualizações no Código Penal Brasileiro têm tipificado severamente a criação e distribuição de deepfakes não consensuais, especialmente aqueles com intuito sexual ou de difamação. Ignorar essas fronteiras não é apenas uma violação ética das regras da plataforma; é um risco legal real.
Mantenha estes limites:
- Cada personagem retratado deve ter inequivocamente 18 anos ou mais.
- Não use enquadramentos de idade escolar, ambiguidade de idade ou pistas de "quase legal".
- Não crie material de pessoa real coercitivo, explorador ou não consensual.
- Não apresente filmagens geradas como evidência de um evento real.
- Não use mídia sintética para assediar, extorquir, personificar ou enganar.
- Siga as regras do serviço e as leis que se aplicam onde você mora.
A investigação do FTC sobre chatbots de companheira de IA destaca as restrições de idade, o tratamento de dados, as divulgações e o tratamento de temas sexuais envolvendo menores como áreas de preocupação regulatória. Veja a investigação do FTC sobre chatbots. O Perfil de IA Generativa do NIST é um recurso mais amplo de gerenciamento voluntário de riscos para desenvolvedores e operadores; enfatiza o gerenciamento de riscos generativos ao longo do ciclo de vida, em vez de presumir que a saída é confiável apenas porque parece polida. Veja o Perfil de IA Generativa do NIST.
Para sua própria privacidade, omita nomes legais, locais, detalhes do empregador, fotos privadas e segredos de terceiros dos prompts. A orientação do ICO do Reino Unido explica que a minimização de dados significa processar apenas os dados pessoais necessários para a finalidade. Esse é um hábito pessoal sensato, mesmo quando uma lei de privacidade específica não se aplica a você. Veja a orientação do ICO sobre segurança de IA e minimização de dados.
Orce o tempo de geração e os créditos de forma realista
O vídeo custa mais computação do que o texto e geralmente mais do que uma imagem estática. A geração de vídeo exige que clusters de GPUs de alta performance (como H100s ou A100s) processem bilhões de parâmetros através de múltiplas camadas de difusão para cada único quadro, multiplicando o custo por 24 ou 30 frames por segundo. Isso não informa o preço de varejo: os provedores empacotam assinaturas, créditos, durações e filas de maneiras diferentes. Verifique a página de planos do MyWifu ao vivo para o acesso atual e faça o mesmo para qualquer outra ferramenta.
Antes de gerar, pergunte:
- Qual é a duração e a resolução do clip?
- Uma solicitação consome um número fixo de créditos?
- Trabalhos falhos são repetidos ou reembolsados?
- Posso sair da página enquanto o trabalho é executado?
- O resultado permanece no chat ou em uma galeria?
- Posso excluí-lo?
- O processamento prioritário depende do plano?
Use um orçamento de três passagens. A passagem um prova a identidade com pouco movimento. A passagem dois melhora a expressão e a câmera. A passagem três tenta a versão ambiciosa. Se a passagem um falhar gravemente, não gaste cinco novas tentativas no mesmo prompt sobrecarregado. Conserte a referência ou simplifique a tomada.
Separe o "tempo de fila" da falsa suspense. Um serviço deve mostrar que o trabalho está sendo processado e eventualmente relatar sucesso ou falha. Nenhum artigo pode prometer um tempo de geração exato porque a carga, a duração, a capacidade do provedor, as novas tentativas e as verificações de moderação variam.
Um fluxo de trabalho completo para o seu primeiro vídeo
- Escolha uma companheira ou crie uma adulta fictícia original.
- Escolha uma referência limpa e bem iluminada que corresponda ao enquadramento desejado.
- Escolha uma ação e um comportamento de câmera.
- Escreva um prompt com cerca de duas ou três frases focadas.
- Confirme o custo atual de créditos e as regras de geração.
- Gere a versão mais simples primeiro.
- Revise identidade, movimento, anatomia, estabilidade da cena e entrega.
- Mude uma variável de cada vez: movimento, câmera ou ambiente.
- Salve apenas um resultado que você ficaria confortável em rotular como gerado por IA.
- Exclua mídia falha ou indesejada de acordo com os controles do serviço.
Solucione problemas do resultado pelo sintoma
Quando um clip falha, reescreva a causa em vez de decorar o prompt com "alta qualidade" dez vezes. Os prompts negativos, quando suportados, podem nomear defeitos, mas eles funcionam como guardas, não como reparos. Um plano físico positivo continua sendo necessário.
| Sintoma | Ponto de pressão provável | Próxima tentativa |
|---|---|---|
| Rosto muda no meio | Virada, oclusão, referência fraca, grande movimento de câmera | Trave a câmera, mantenha o rosto visível, use uma fonte mais próxima |
| Personagem fica mais jovem | Fonte ambígua ou pistas de idade | Use uma âncora inegavelmente adulta e idade adulta explícita; rejeite saída incerta |
| Mãos derretem em objeto | Agarre complexo ou mão cruzando o corpo | Remova o adereço ou peça um gesto de mão aberta |
| Roupa cintila | Alças finas, tecido em camadas, virada do corpo | Use uma roupa mais simples e movimento menor |
| Fundo entorta | Órbita da câmera ou arquitetura densa | Use câmera estática e fundo com foco raso |
| Movimento parece congelado | Prompt descreve clima, mas sem ação | Adicione um verbo visível e um estado inicial claro |
| Movimento é frenético | Muitos verbos ou solicitação "dinâmica" vaga | Mantenha uma ação e especifique timing lento e contido |
| Clip termina abruptamente | Ação não pode terminar dentro da duração | Peça uma ação menor com um final natural e mantido |
Mude um fator por nova tentativa. Se você mudar a fonte, a câmera, a ação, o guarda-roupa e a luz juntos, não poderá aprender qual condição importou.
Para um rosto que diverge apenas no final, encurte a ação conceitual: "começa a sorrir e mantém contato visual" em vez de "sorri, ri, vira para longe, depois olha para trás". Para um corpo que se deforma ao caminhar, reduza a distância e use um rastreamento da cintura para cima. Para um adereço que muda de forma, remova-o até que o movimento do personagem funcione.
Planeje uma pequena sequência em vez de um clip impossível
Se você quer um momento mais rico, divida-o em tomadas. Uma sequência de encontro de três tomadas pode ser:
- Imagem ampla de estabelecimento de uma mesa no terraço ao pôr do sol.
- Clip médio da companheira virando e levantando uma taça.
- Clip fechado de um pequeno sorriso e contato visual direto.
Cada tomada tem uma escala e uma ação. Você pode gerá-las a partir de referências consistentes e depois editá-las juntas fora do gerador, se permitido. Esta abordagem é mais controlável do que exigir uma tomada ampla, revelação de figurino, órbita, brinde, diálogo e close em uma saída curta.
Mantenha uma folha de continuidade:
- Imagem âncora do personagem e descrição da identidade
- Roupa e acessórios exatos
- Hora do dia e direção da luz
- Paleta de localização e objetos importantes
- Proporção da câmera e estilo visual
- Ordem de tomada pretendida
A continuidade se torna mais difícil quando cada prompt parafraseia o guarda-roupa. Reutilize a descrição estável. Se o serviço anexar a identidade do personagem automaticamente, foque o prompt no movimento e na cena, em vez de redefinir o rosto dela a cada vez.
O áudio é uma escolha de produção separada. Um visual silencioso com uma nota de voz posterior pode ser mais confiável do que tentar fala sincronizada com os lábios na mesma geração. Se a fala for suportada, use uma linha curta, teste a pronúncia e inspecione o movimento dos lábios. Não clone uma voz real sem permissão.
Publique vídeo de companheira sintética de forma responsável
Um clip privado e uma postagem pública têm riscos diferentes. Antes de postar, inspecione as regras da plataforma, os direitos de música, os requisitos de divulgação de mídia gerada e se o personagem se assemelha a uma pessoa real. Remova nomes de arquivos pessoais e pistas de localização. Não insinue que a cena documenta um evento real.
Use uma legenda clara como "Personagem fictícia gerada por IA". Uma hashtag sozinha pode ser ignorada. Metadados de proveniência podem adicionar contexto, mas não devem ser sua única divulgação, pois as plataformas sociais podem remover metadados de arquivos.
Se alguém perguntar se a pessoa é real, responda com franqueza. A conquista criativa não se torna menos interessante por ser sintética. A transparência protege os espectadores e protege sua identidade fictícia original de ser confundida com filmagens roubadas.
Arquive o prompt final, o ativo de origem, a data de geração e a ferramenta usada se você planeja uma série. Esse registro ajuda a reproduzir o estilo, corrigir a continuidade e explicar a proveniência mais tarde. Mantenha os ativos de origem privados separados das exportações públicas.
Combine o movimento com a duração do clip
Um clip curto precisa de uma ação que seja lida imediatamente. Piscar natural, um olhar, um pequeno sorriso, uma caminhada de dois passos ou levantar uma xícara podem começar e se estabilizar em segundos. Uma ação com configuração, viagem, interação com objeto e reação pode terminar no meio do gesto.
Escreva o movimento como três momentos: pose inicial, transição, final mantido. "Ela começa a olhar pela janela, vira-se para a câmera com um sorriso tranquilo e depois mantém contato visual" dá ao gerador um lugar estável para terminar e facilita a edição.
Preserve a qualidade após o download
Assista ao original antes de enviá-lo por um mensageiro que pode recomprimir o vídeo. Mantenha uma cópia de arquivo. Ao cortar, preserve o rosto e o movimento pretendido, em vez de forçar cada clip em uma proporção. Exportar maior do que a fonte gerada não restaura detalhes perdidos.
Se você adicionar legendas, coloque-as longe da anatomia importante e identifique o personagem como sintético. Use áudio licenciado ou original. Compare as versões no tamanho real de entrega: a reprodução no telefone pode ocultar defeitos, enquanto a compressão pode introduzir nova cintilação.
Prepare a imagem de origem para o movimento
A imagem de referência deve deixar espaço físico para a ação solicitada. Um rosto fortemente cortado não pode convincentemente se tornar uma caminhada de corpo inteiro, e uma mão escondida atrás de móveis não dá ao gerador nenhuma geometria inicial confiável para um aceno. Selecione uma fonte onde os membros relevantes estejam visíveis, a pose esteja equilibrada e os objetos em primeiro plano não se fundam com a silhueta.
Combine a solicitação da câmera com essa evidência. Peça uma virada sutil de cabeça a partir de um retrato, um gesto sentado a partir de uma imagem da cintura para cima ou uma pequena mudança de peso a partir de um quadro de corpo inteiro. Mantenha o fundo simples quando a identidade importa mais do que o espetáculo. Antes de gastar outra geração, inspecione se a própria fonte contém dedos deformados, joias inconsistentes, texto ilegível ou bordas ambíguas. A animação tende a amplificar esses defeitos. Uma imagem estática mais limpa e um movimento menor frequentemente superam um prompt mais elaborado construído sobre informações visuais fracas.
O objetivo criativo não é o movimento máximo. É um clip que parece o mesmo personagem executando uma ação crível. Comece contido, preserve a identidade e construa complexidade apenas depois que a fundação funcionar.
Quando você estiver pronto, navegue pelas companheiras do MyWifu, construa a sua e revise o acesso atual a vídeo. Mantenha a pessoa fictícia, claramente adulta e inegavelmente sintética quando compartilhada.
Perguntas frequentes
O que é um gerador de video de namorada ia?
É uma ferramenta generativa que cria um vídeo sintético de uma companheira adulta fictícia, geralmente a partir de uma imagem de referência combinada com um prompt de movimento ou cena. É diferente de uma chamada de vídeo ao vivo.
Como mantenho o mesmo rosto em um vídeo de IA?
Use uma referência clara de um único personagem, descreva traços de identidade estáveis, solicite uma ação simples, evite cortes rápidos e regenere a partir da imagem de origem mais forte quando a identidade divergir.
Por que mãos e rostos mudam durante um clip?
A geração de vídeo precisa manter a aparência em muitos quadros enquanto produz movimento. Oclusão, movimento rápido, reflexos e contatos complexos tornam esse problema de consistência mais difícil.
Devo escrever um prompt de vídeo longo?
Geralmente não. Um prompt compacto com sujeito, uma ação, comportamento da câmera, cenário, luz e clima é mais fácil de seguir do que um parágrafo de instruções concorrentes.
Posso gerar um vídeo explícito de companheira IA?
Isso depende do serviço e da lei local. Use apenas adultos fictícios, siga as regras da plataforma e nunca gere mídia íntima ou sexual retratando uma pessoa real sem consentimento explícito.
Um clip gerado é o mesmo que uma chamada de vídeo com IA?
Não. Um clip gerado é renderizado a partir de um prompt e entregue após o processamento. Uma chamada de vídeo é interativa e responde em tempo real, mesmo que use um avatar animado ou gerado.
Quantas tentativas um bom clip vai exigir?
Não há um número fixo confiável. Movimento simples e uma referência forte melhoram as chances, mas a saída generativa varia. Verifique as políticas de nova tentativa, créditos e gerações falhas antes de gastar.
Deixe do seu jeito
Conheça uma companheira feita para você.
Escolha uma personalidade, comece uma conversa privada e explore fotos, vídeos e voz quando quiser.
Descobrir companheiras